自定义作业
本文提供自定义Flink作业场景的实施思路、配置示例和验证方式,可作为实际项目配置参考。
通过编写Java代码,自定义Flink计算逻辑
参考地址
https://github.com/isxcode/flink-job-template
示例本地编译
git clone https://github.com/isxcode/flink-job-template.git
cd flink-job-template
./gradlew clean build
cp ./build/libs/flink-custom-job.jar ~/Downloads
核心代码
逻辑: 获取传入参数args中的第一个参数,该参数为一句sql。执行sql处理my_source中的数据同步到print_sink中并打印。
package com.isxcode.acorn.job;

import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.table.api.EnvironmentSettings;
import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;

public class Job {

    public static void main(String[] args) {

        // 从args中获取参数
        String sql = args[0];

        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        EnvironmentSettings settings = EnvironmentSettings.newInstance().inStreamingMode().build();
        StreamTableEnvironment streamTableEnvironment = StreamTableEnvironment.create(env, settings);

        String flinkSql = "CREATE TABLE my_source (\n" +
                "    id INT,\n" +
                "    name STRING\n" +
                ") WITH (\n" +
                "    'connector' = 'datagen',  -- 指定连接器为 datagen\n" +
                "    'rows-per-second' = '10',  -- 每秒生成的行数\n" +
                "    'fields.id.kind' = 'sequence',  -- id 字段的生成方式为递增\n" +
                "    'fields.id.start' = '1',  -- id 的起始值\n" +
                "    'fields.id.end' = '100',  -- id 的最大值\n" +
                "    'fields.name.kind' = 'random',  -- name 字段生成随机字符串\n" +
                "    'fields.name.length' = '10'  -- name 字符串的长度\n" +
                ");\n" +
                "\n" +
                "CREATE TABLE print_sink ( \n" +
                "    count_number bigint \n" +
                ") WITH ( \n" +
                "    'connector' = 'print' \n" +
                ");\n" +
                "\n" + sql;

        for (String s : flinkSql.split(";")) {
            streamTableEnvironment.executeSql(s);
        }
    }
}
使用模板
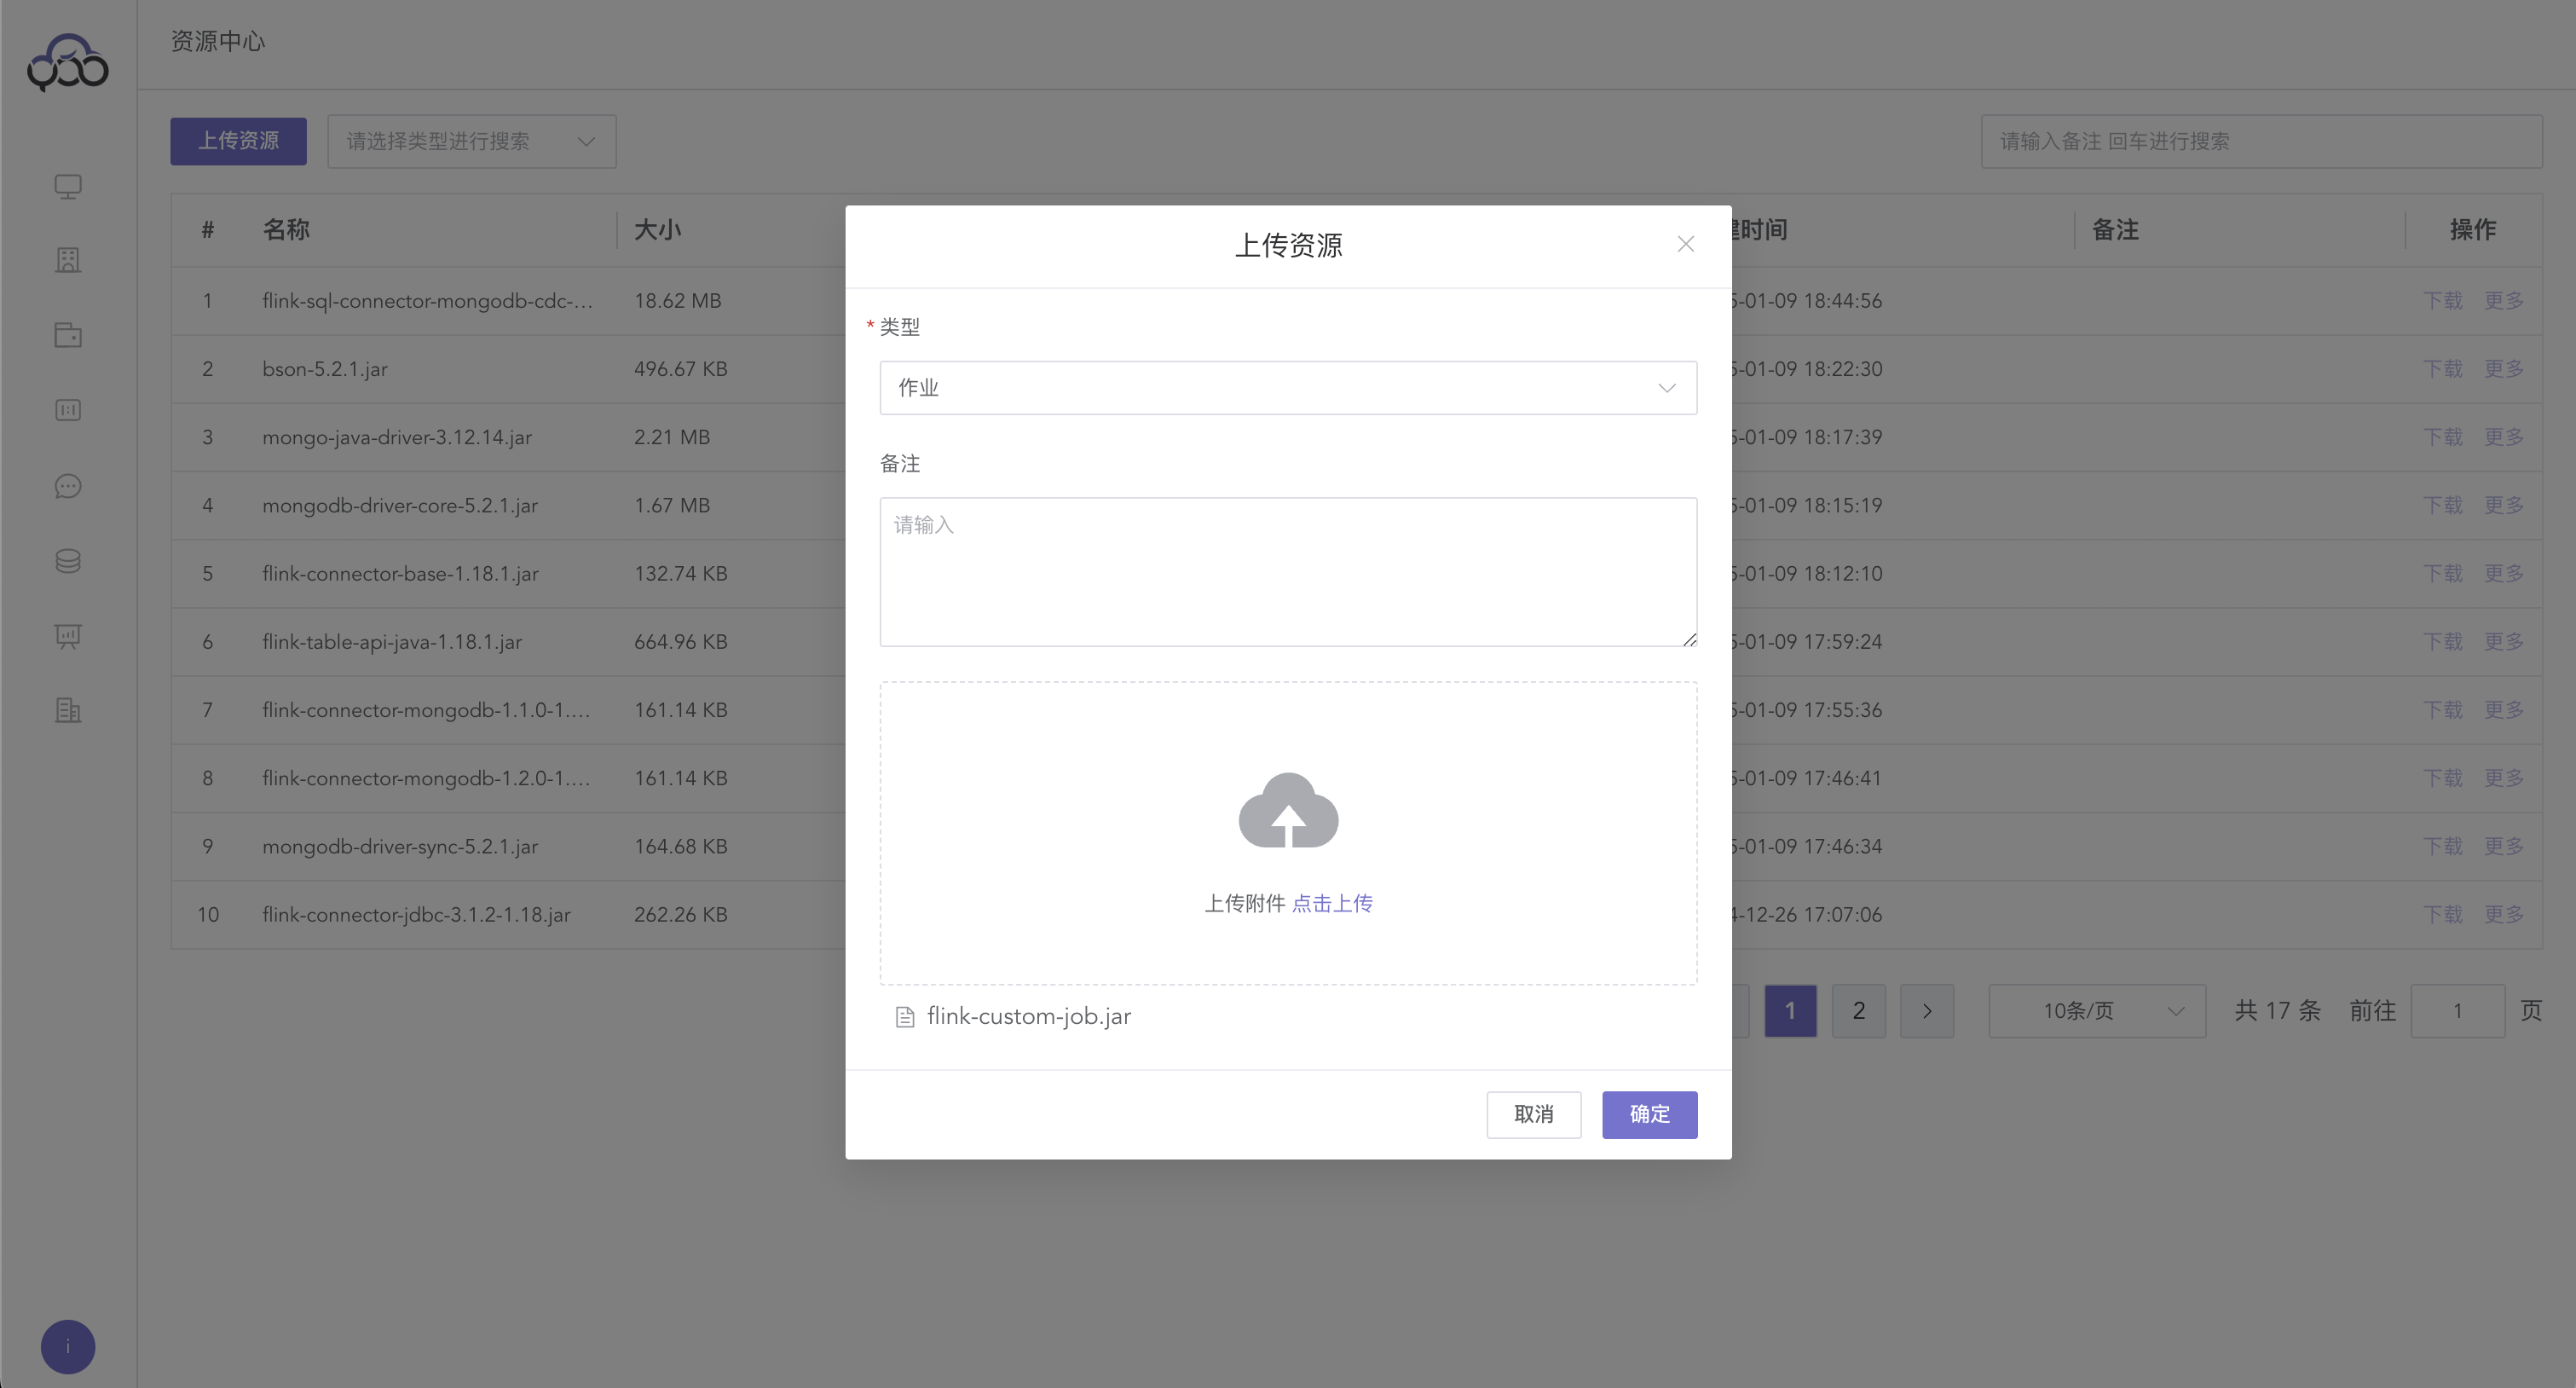
上传自定义Jar 包,选择
作业类型
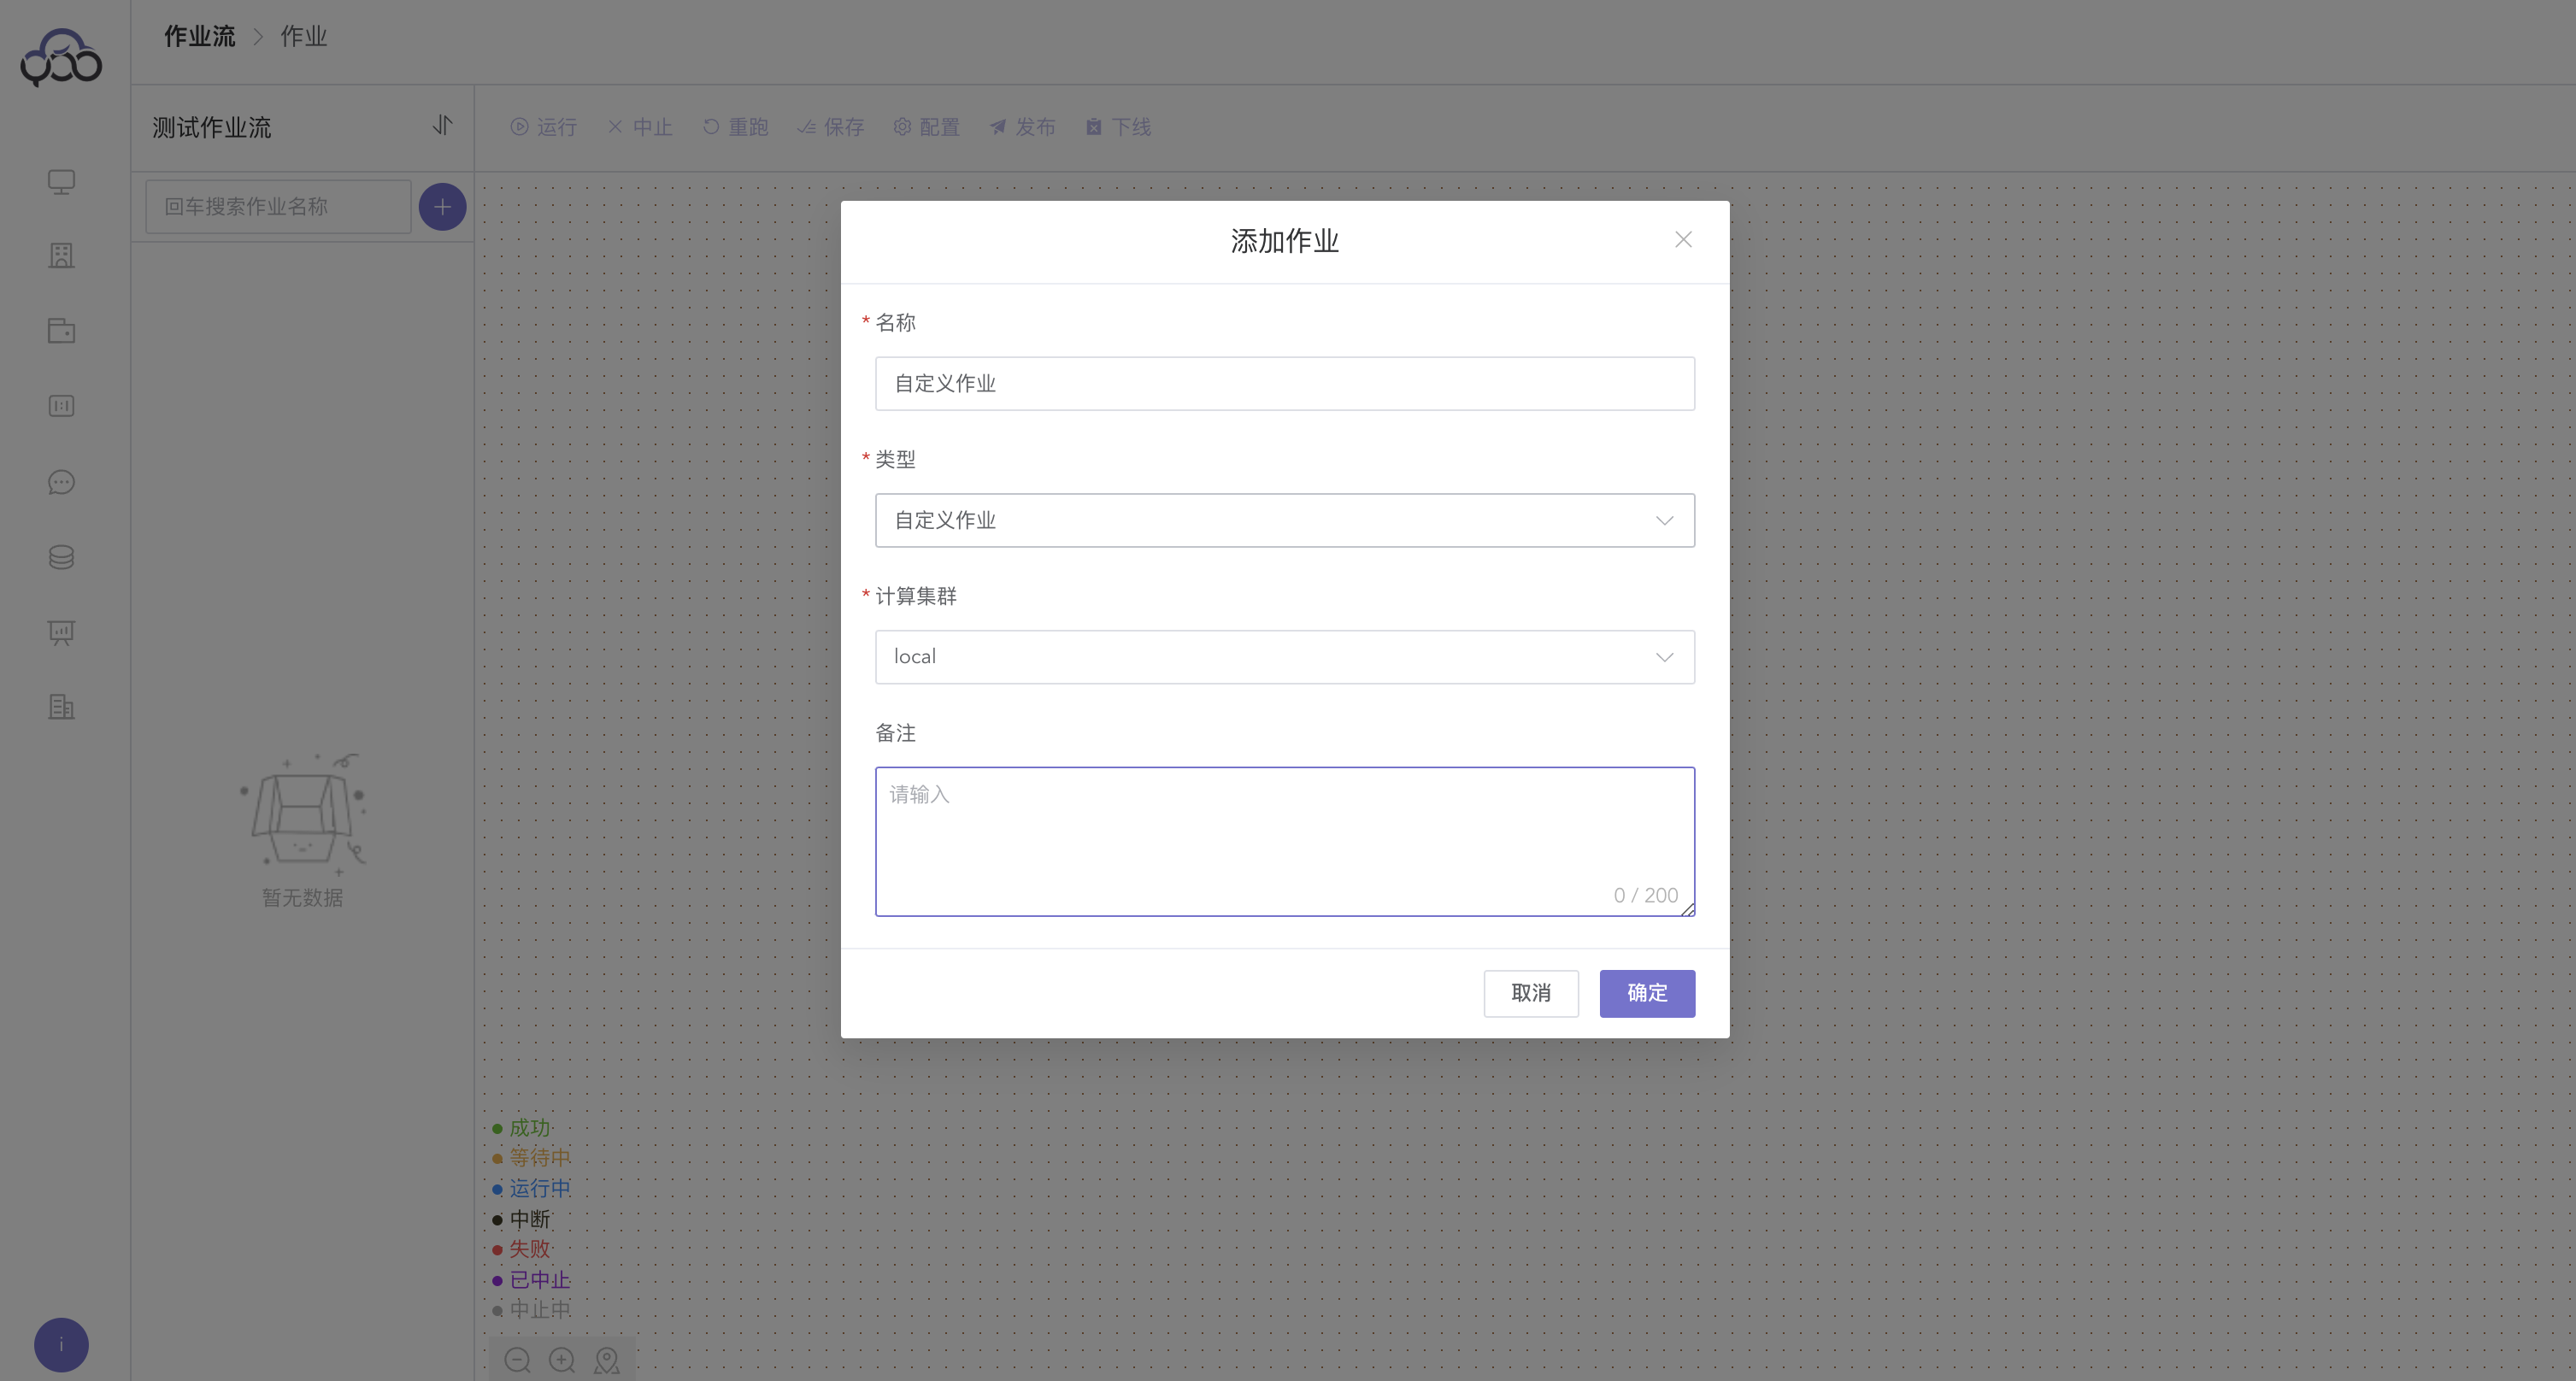
新建
自定义作业
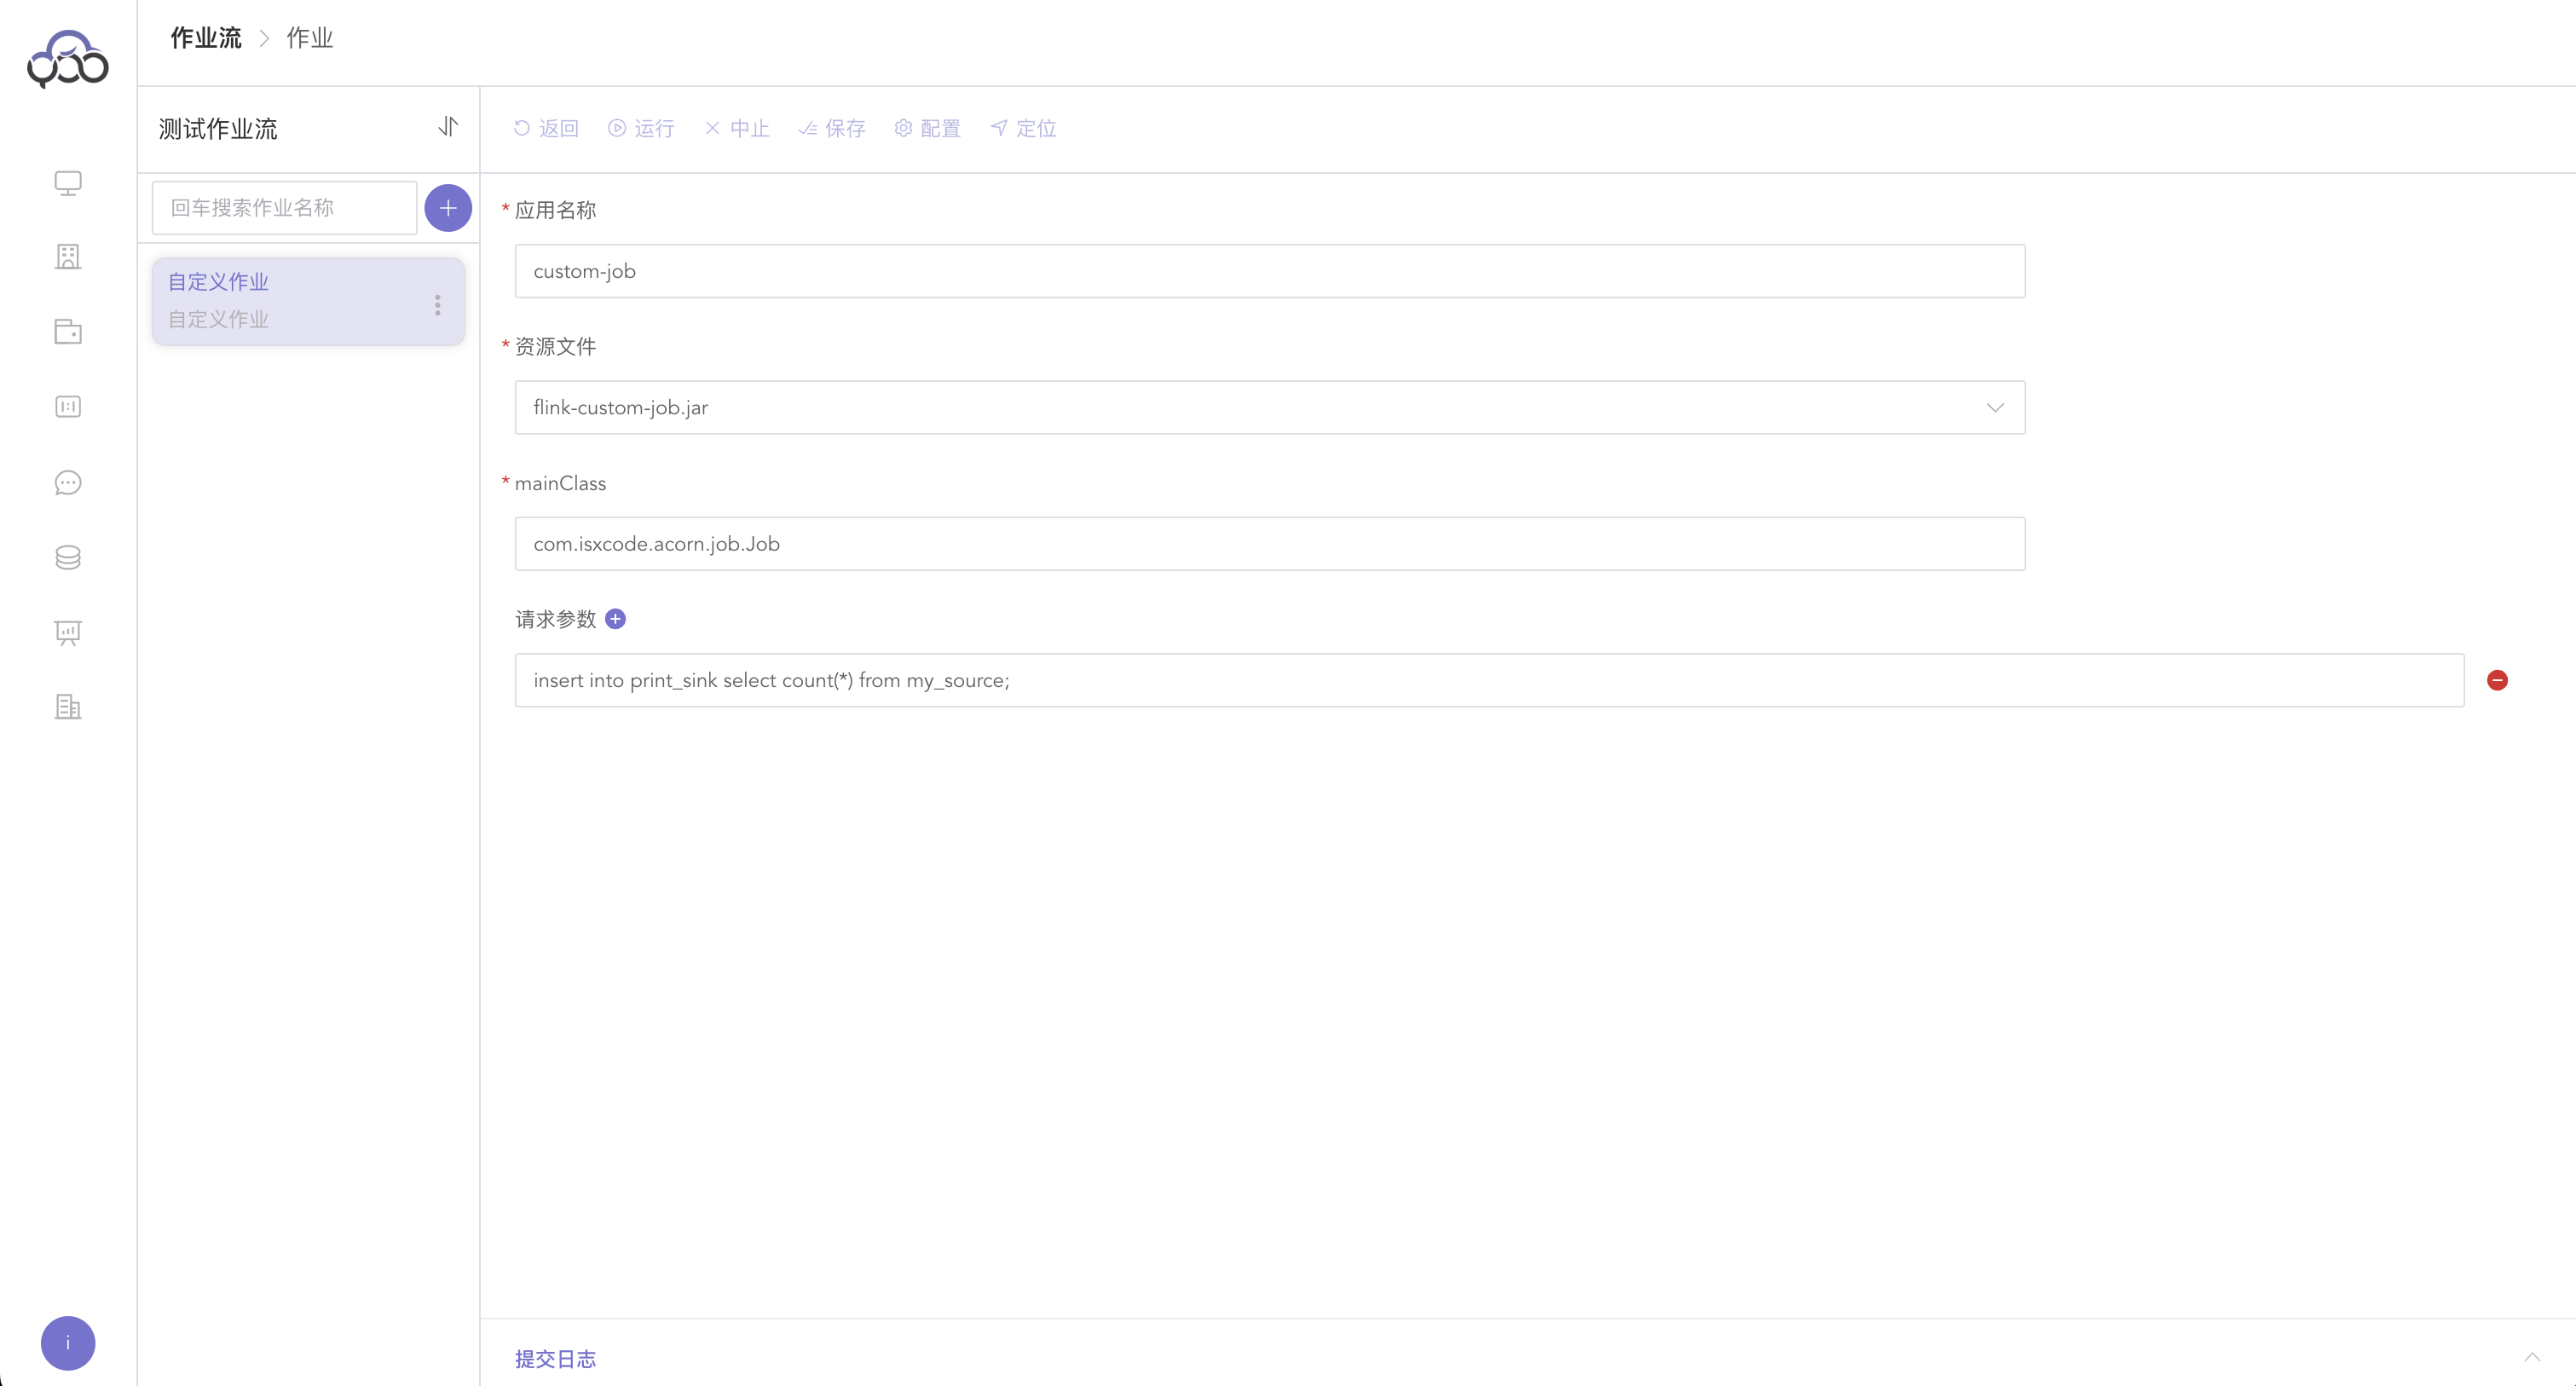
应用名称:custom-job mainClass:com.isxcode.acorn.job.Job 请求参数:insert into print_sink select count(*) from my_source;
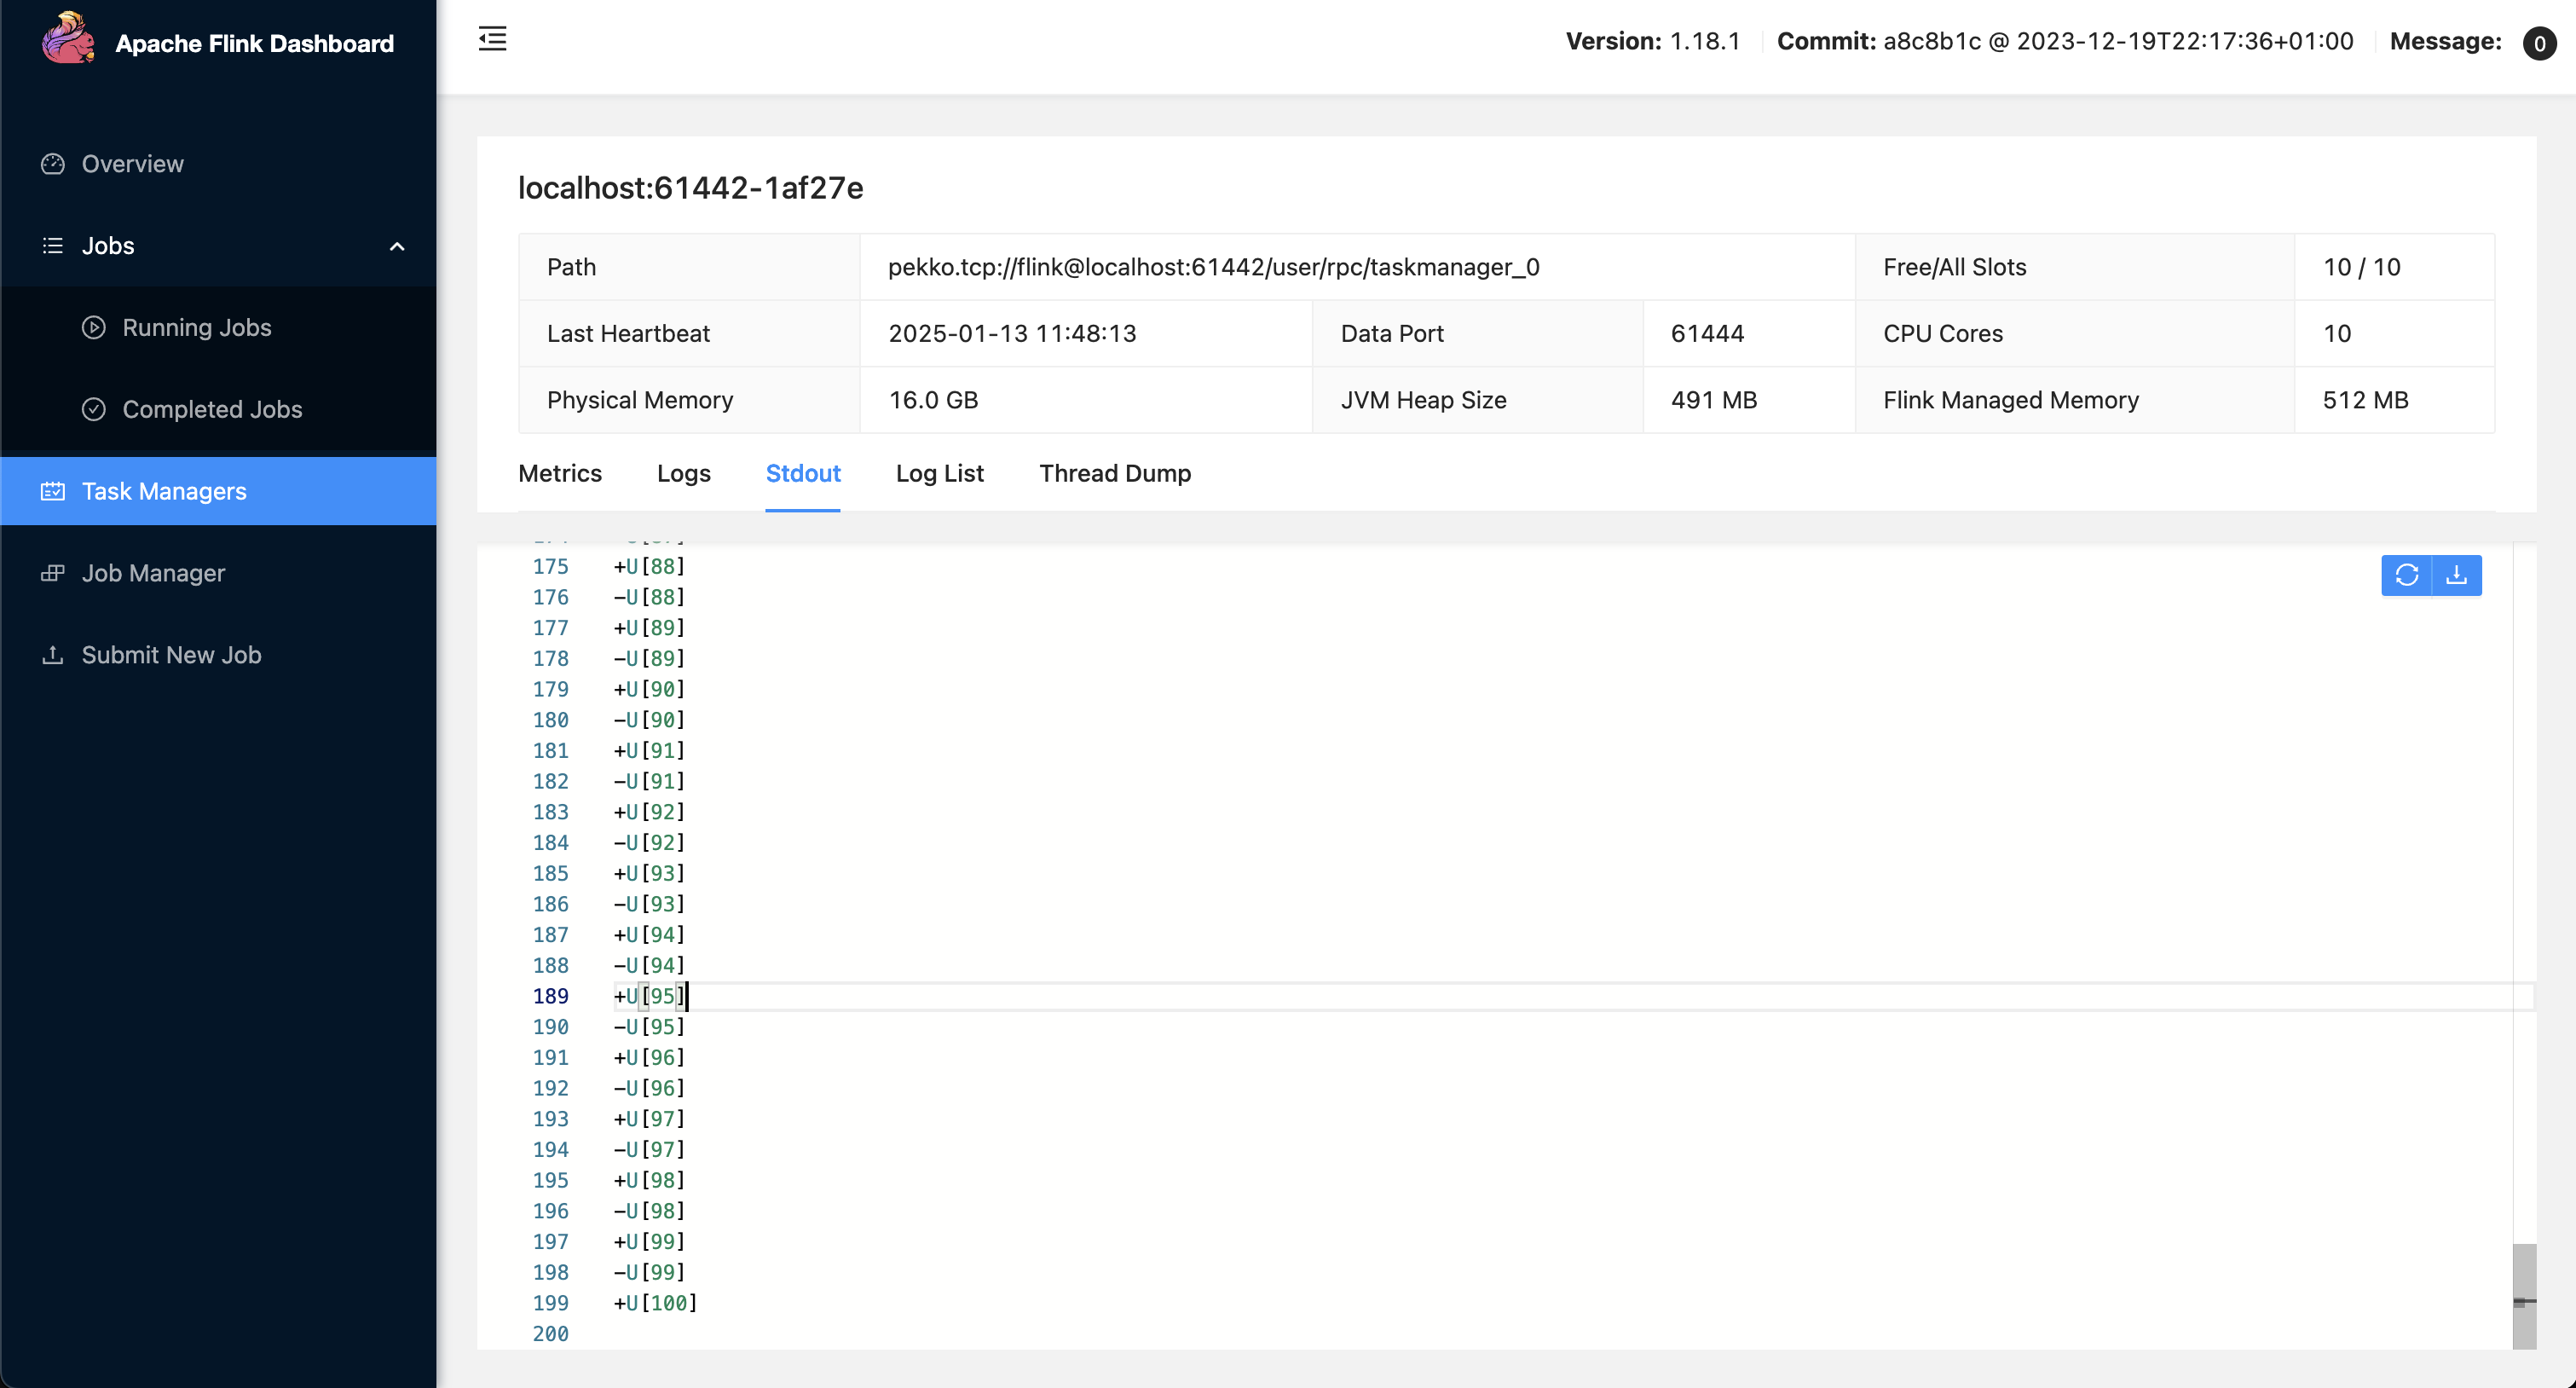
查看结果
由于'connector' = 'print'是flink官方连接器,至轻云无法获取数据,需要在ui界面查看数据