
Spark集成Paimon
本文提供Spark集成Paimon场景的实施方案,包括配置示例、执行步骤和参数说明。
案例
使用spark对Paimon数据进行增删改查
解决方案
创建
Spark SQL查询作业,下载依赖
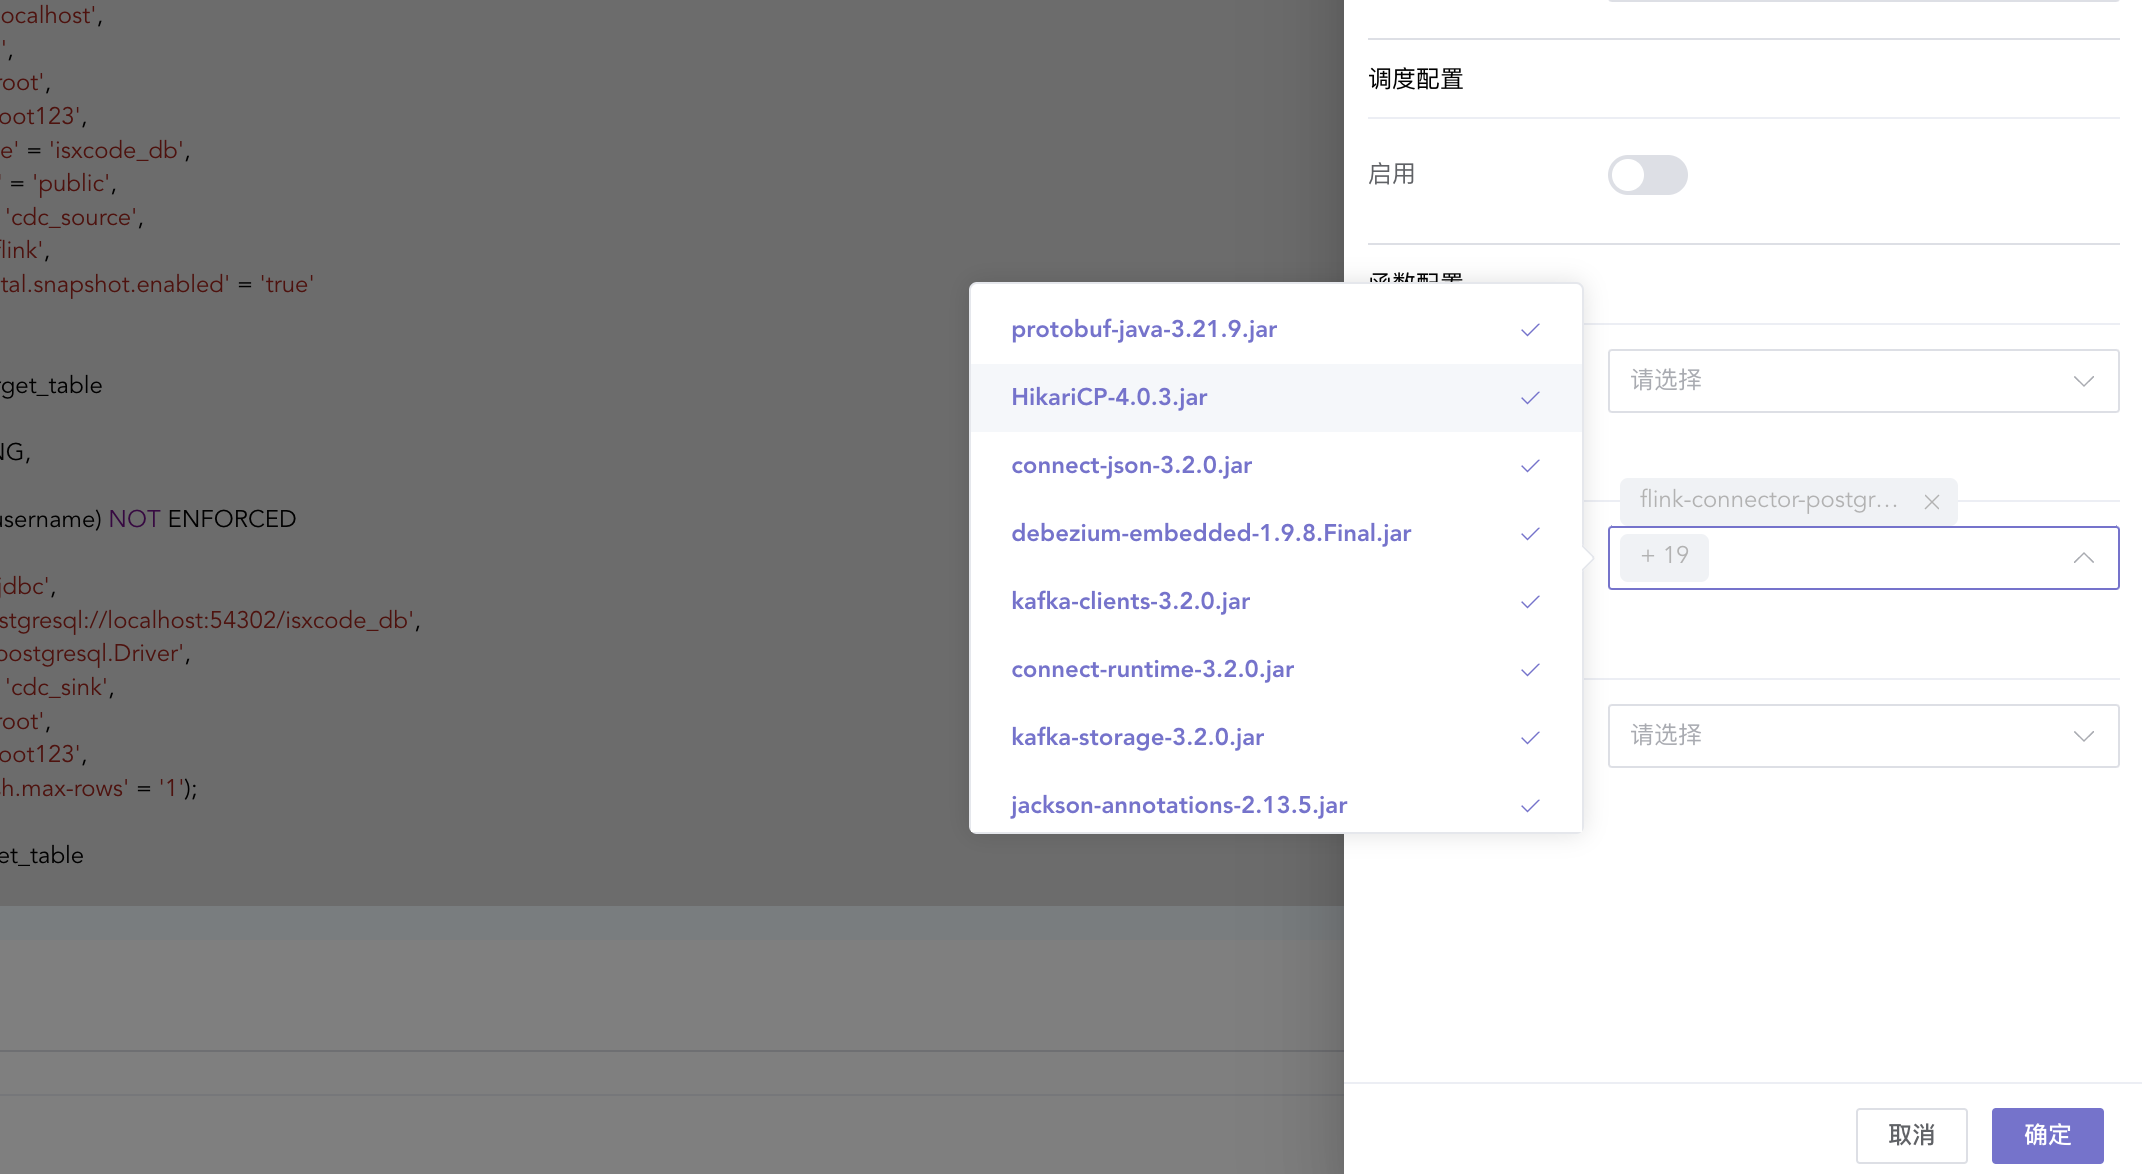
配置SparkConfig
{
  "spark.cores.max": "1",
  "spark.driver.cores": "1",
  "spark.driver.extraJavaOptions": "-Dfile.encoding=utf-8",
  "spark.driver.memory": "1g",
  "spark.executor.cores": "1",
  "spark.executor.extraJavaOptions": "-Dfile.encoding=utf-8",
  "spark.executor.instances": "1",
  "spark.executor.memory": "2g",
  "spark.sql.autoBroadcastJoinThreshold": "-1",
  "spark.sql.catalog.paimon": "org.apache.paimon.spark.SparkCatalog",
  "spark.sql.catalog.paimon.metastore":"hive",
  "spark.sql.catalog.paimon.uri": "thrift://172.19.189.247:9083",
  "spark.sql.catalog.paimon.warehouse": "hdfs://172.19.189.247:9000/user/hive/warehouse",
  "spark.sql.extensions": "org.apache.paimon.spark.extensions.PaimonSparkSessionExtensions",
  "spark.sql.legacy.timeParserPolicy": "LEGACY",
  "spark.sql.parquet.datetimeRebaseModeInRead": "LEGACY",
  "spark.sql.parquet.datetimeRebaseModeInWrite": "LEGACY",
  "spark.sql.parquet.enableVectorizedReader": "false",
  "spark.sql.parquet.int96RebaseModeInRead": "LEGACY",
  "spark.sql.parquet.int96RebaseModeInWrite": "LEGACY",
  "spark.sql.parquet.writeLegacyFormat": "true",
  "spark.sql.storeAssignmentPolicy": "LEGACY"
}
sql增删改查数据
-- 选择数据库
USE paimon.ispong_db;

-- 建表
CREATE TABLE IF NOT EXISTS paimon_table (
    username STRING,
    age INT
)
USING paimon
OPTIONS (
    'bucket' = '4',
    'bucket-key' = 'username',
    'file.format' = 'parquet'
)
COMMENT '用户信息表';

-- 增
insert into paimon_table values ('zhangsan',13);
insert into paimon_table values ('lisi',14);

-- 删
delete from paimon_table where username = 'zhangsan';

-- 改
update paimon_table set age = 122 where username='lisi';

-- 查
select * from paimon_table;