
Flink集成Paimon
本文提供Flink集成Paimon场景的实施方案,包括配置示例、执行步骤和参数说明。
案例
使用flink对Paimon数据进行增删改查
解决方案
创建
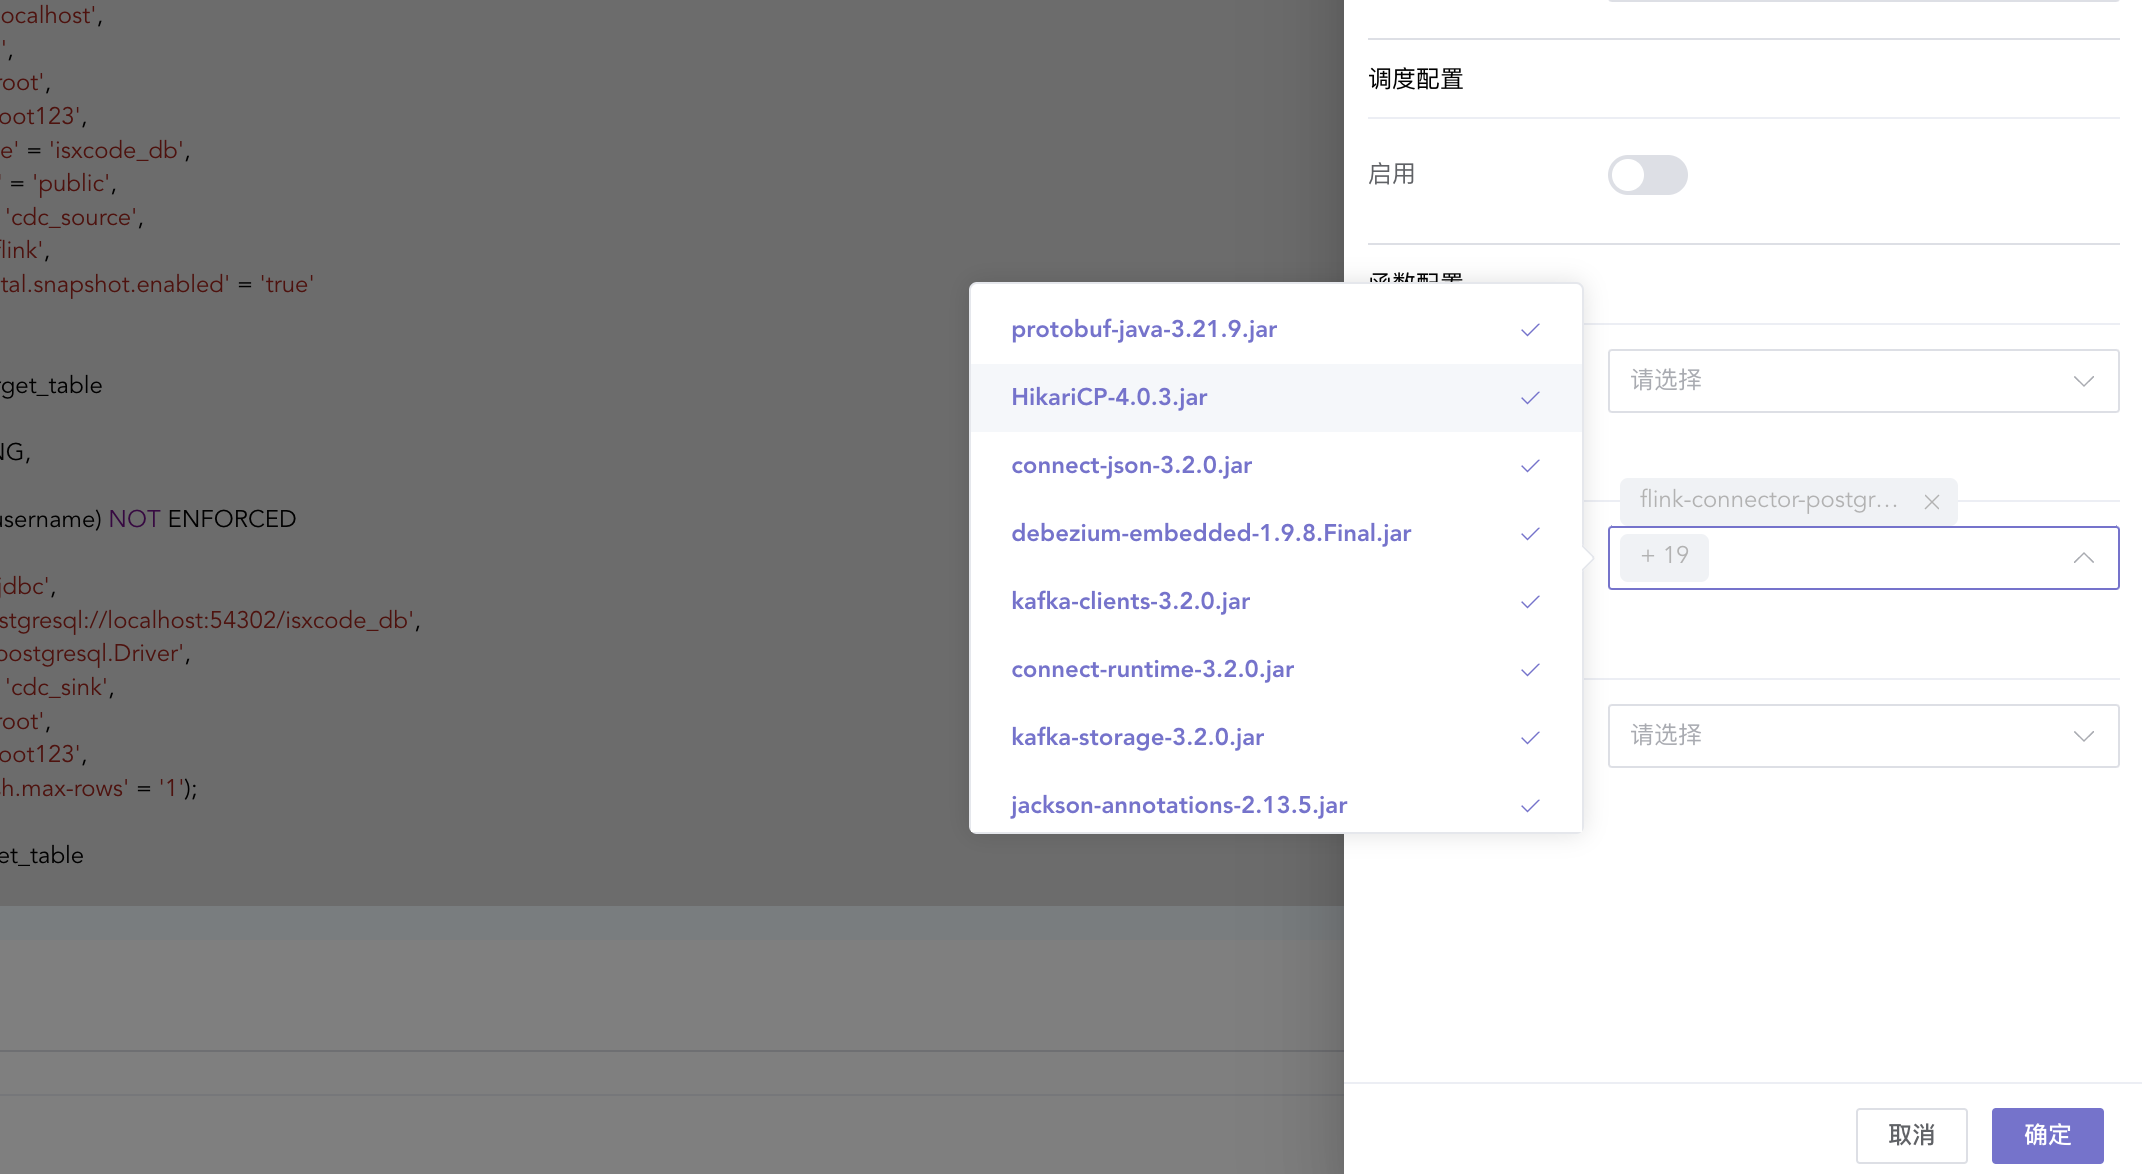
Flink SQL查询作业,下载依赖
- paimon-flink-1.18-1.4-20251105.003055-51.jar下载
- hive-Standalone-metastore-3.1.3.jar下载
- hive-common-3.1.3.jar下载
- hadoop-mapreduce-client-core-3.3.5.jar下载
- commons-lang-2.6.jar下载
- hive-storage-api-4.0.0.jar下载
- libthrift-0.9.3.jar下载
- libfb303-0.9.3.jar下载
- hive-exec-3.1.3.jar下载
Flink SQL
-- 创建Catalog
CREATE CATALOG hive_catalog WITH (
    'type' = 'paimon',
    'warehouse' = 'hdfs://172.19.189.246:9000/user/hive/warehouse',
    'metastore' = 'hive',
    'uri' = 'thrift://172.19.189.246:9083',
    'hive-conf-dir' = '/opt/hive/conf'
);

-- 选择Catalog
USE CATALOG hive_catalog;

-- 选择数据源
USE ispong_db;

-- 创建Paimon表
CREATE TABLE IF NOT EXISTS users_paimon2 (
    username STRING,
    age INT,
    PRIMARY KEY (username) NOT ENFORCED
) WITH (
    'bucket' = '2',
    'bucket-key' = 'username',
    'changelog-producer' = 'lookup'
);

-- 插入数据
INSERT INTO users_paimon2 VALUES
('zhangsan', 13),
('lisi', 14);