
自定义Spark作业
本文提供自定义Spark作业场景的实施方案,包括配置示例、执行步骤和参数说明。
案例说明
运行spark官网的pi计算
案例实现
下载spark官方计算pi的Jar 包
https://openfly.oss-cn-shanghai.aliyuncs.com/spark-examples_2.12-3.4.1.jar
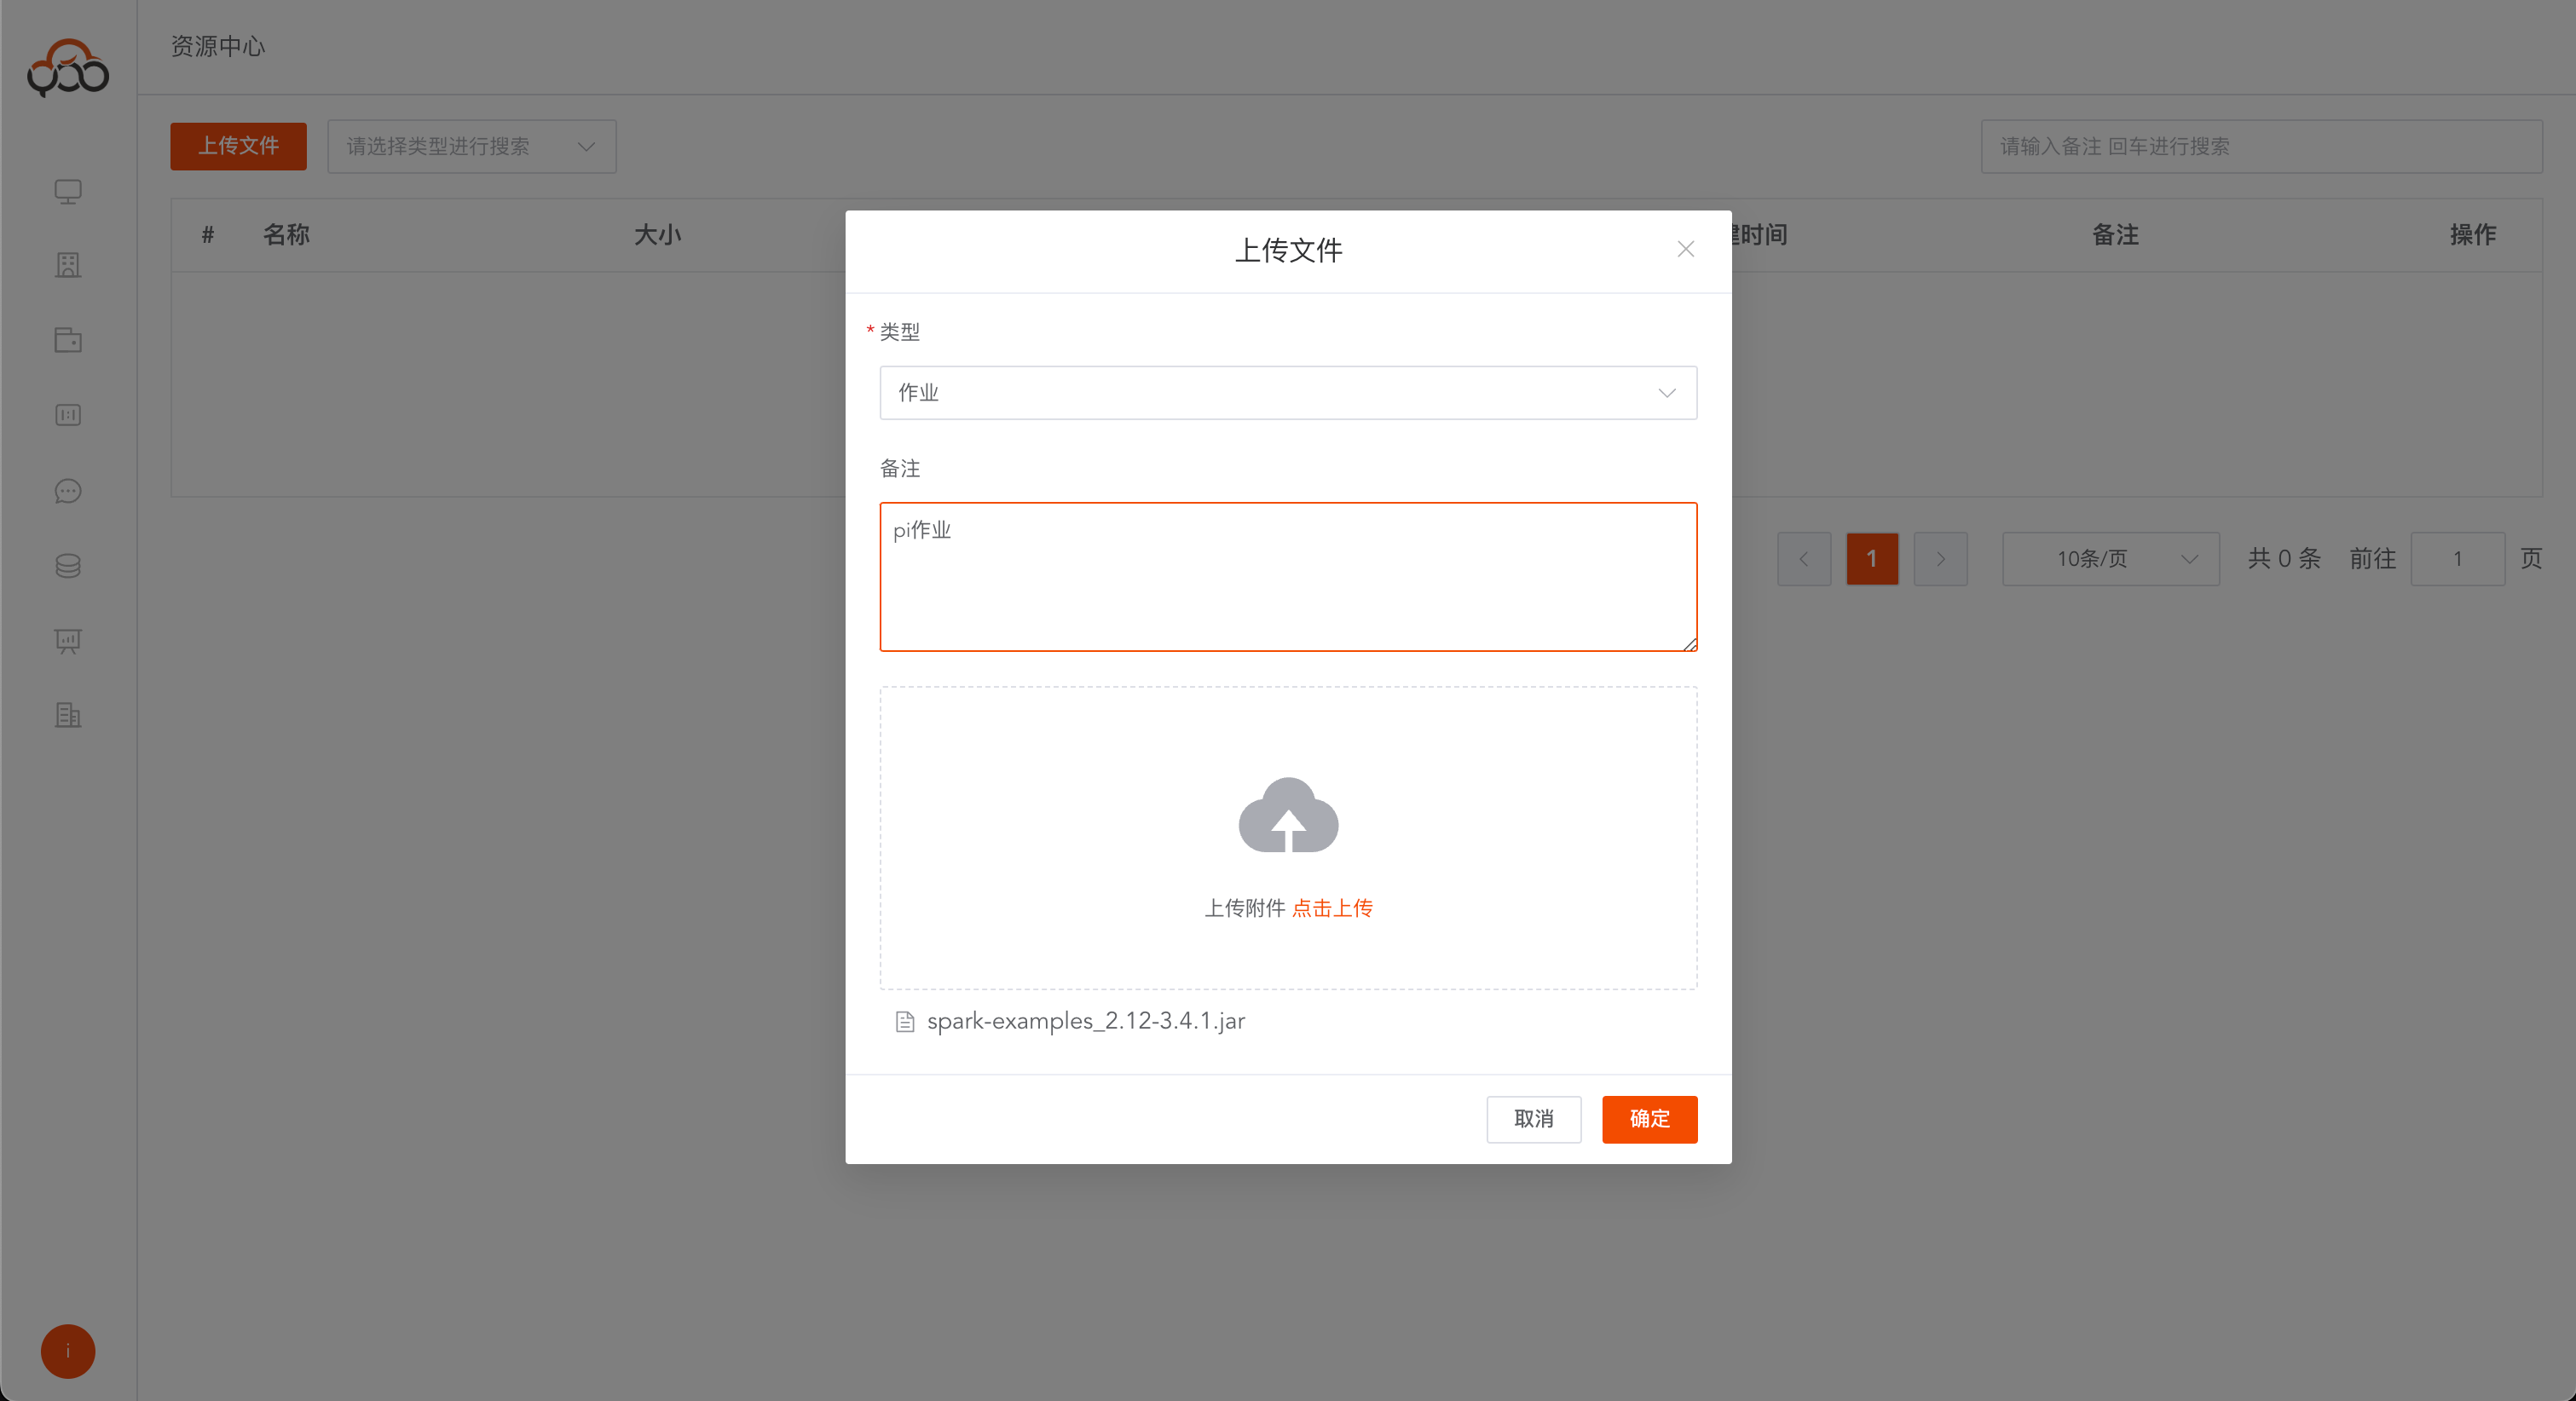
上传资源中心
选择类型:作业
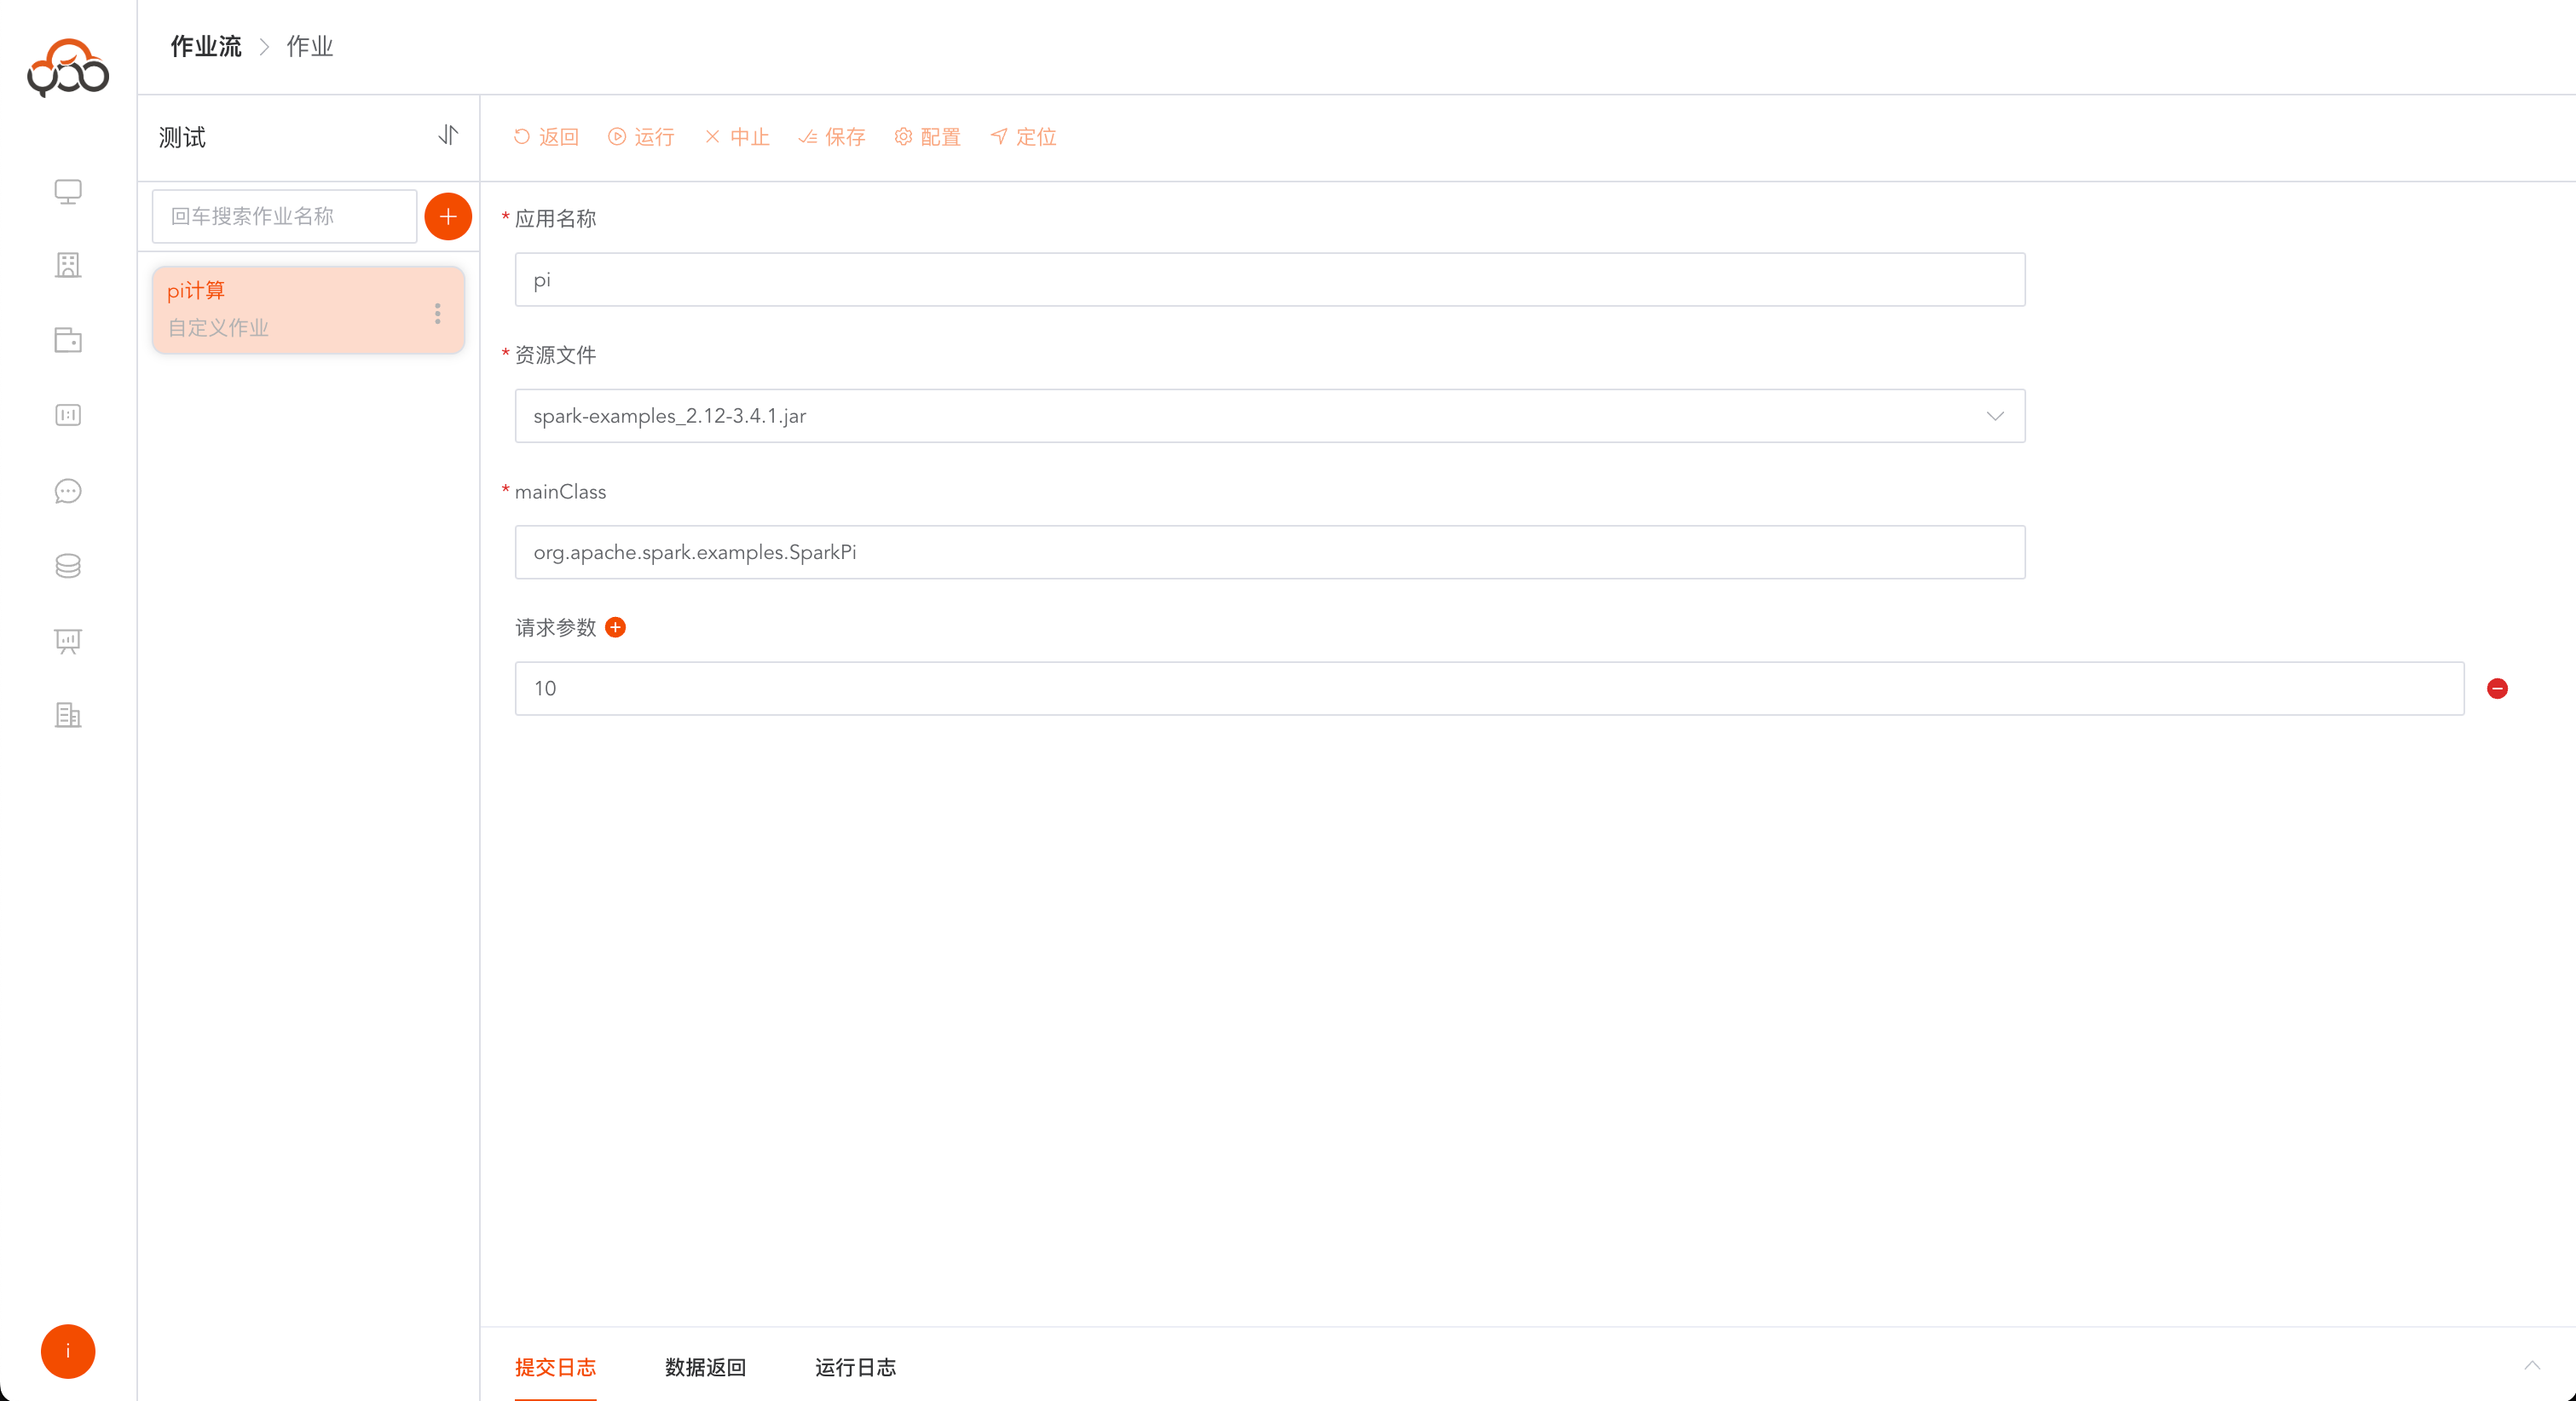
新建自定义作业
应用名称:pi 资源文件:spark-examples_2.12-3.4.1.jar mainClass:org.apache.spark.examples.SparkPi 请求参数:10
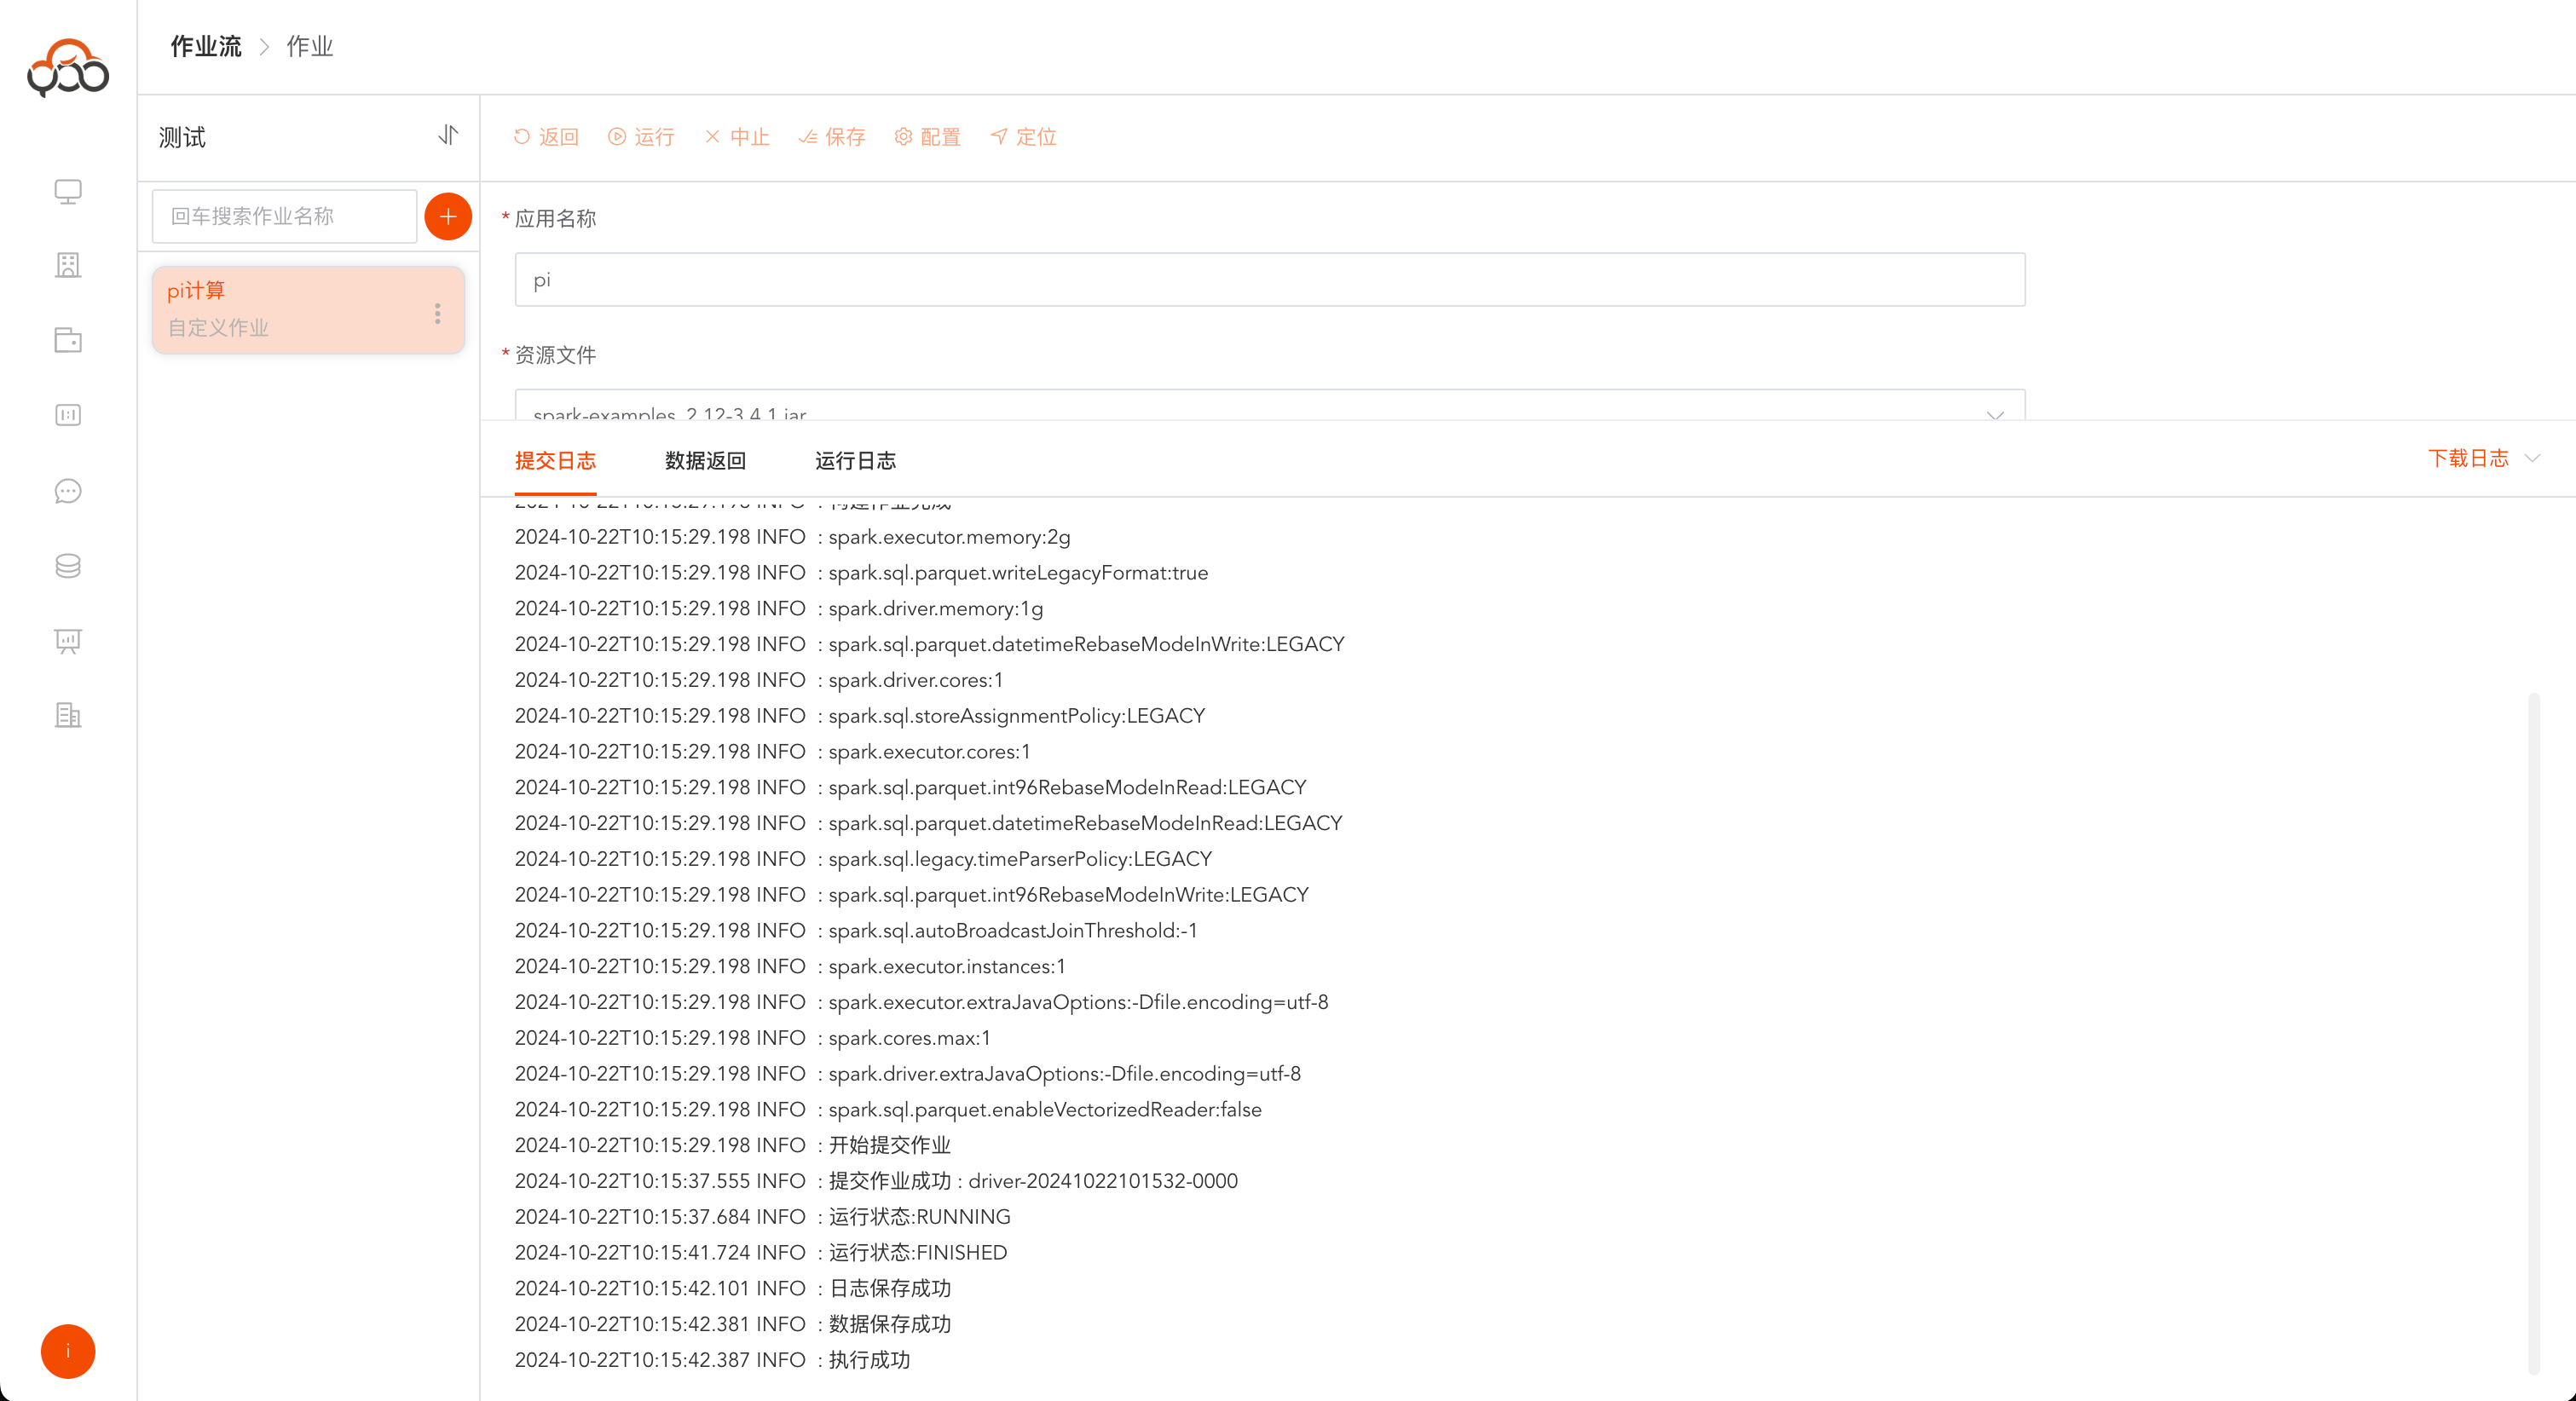
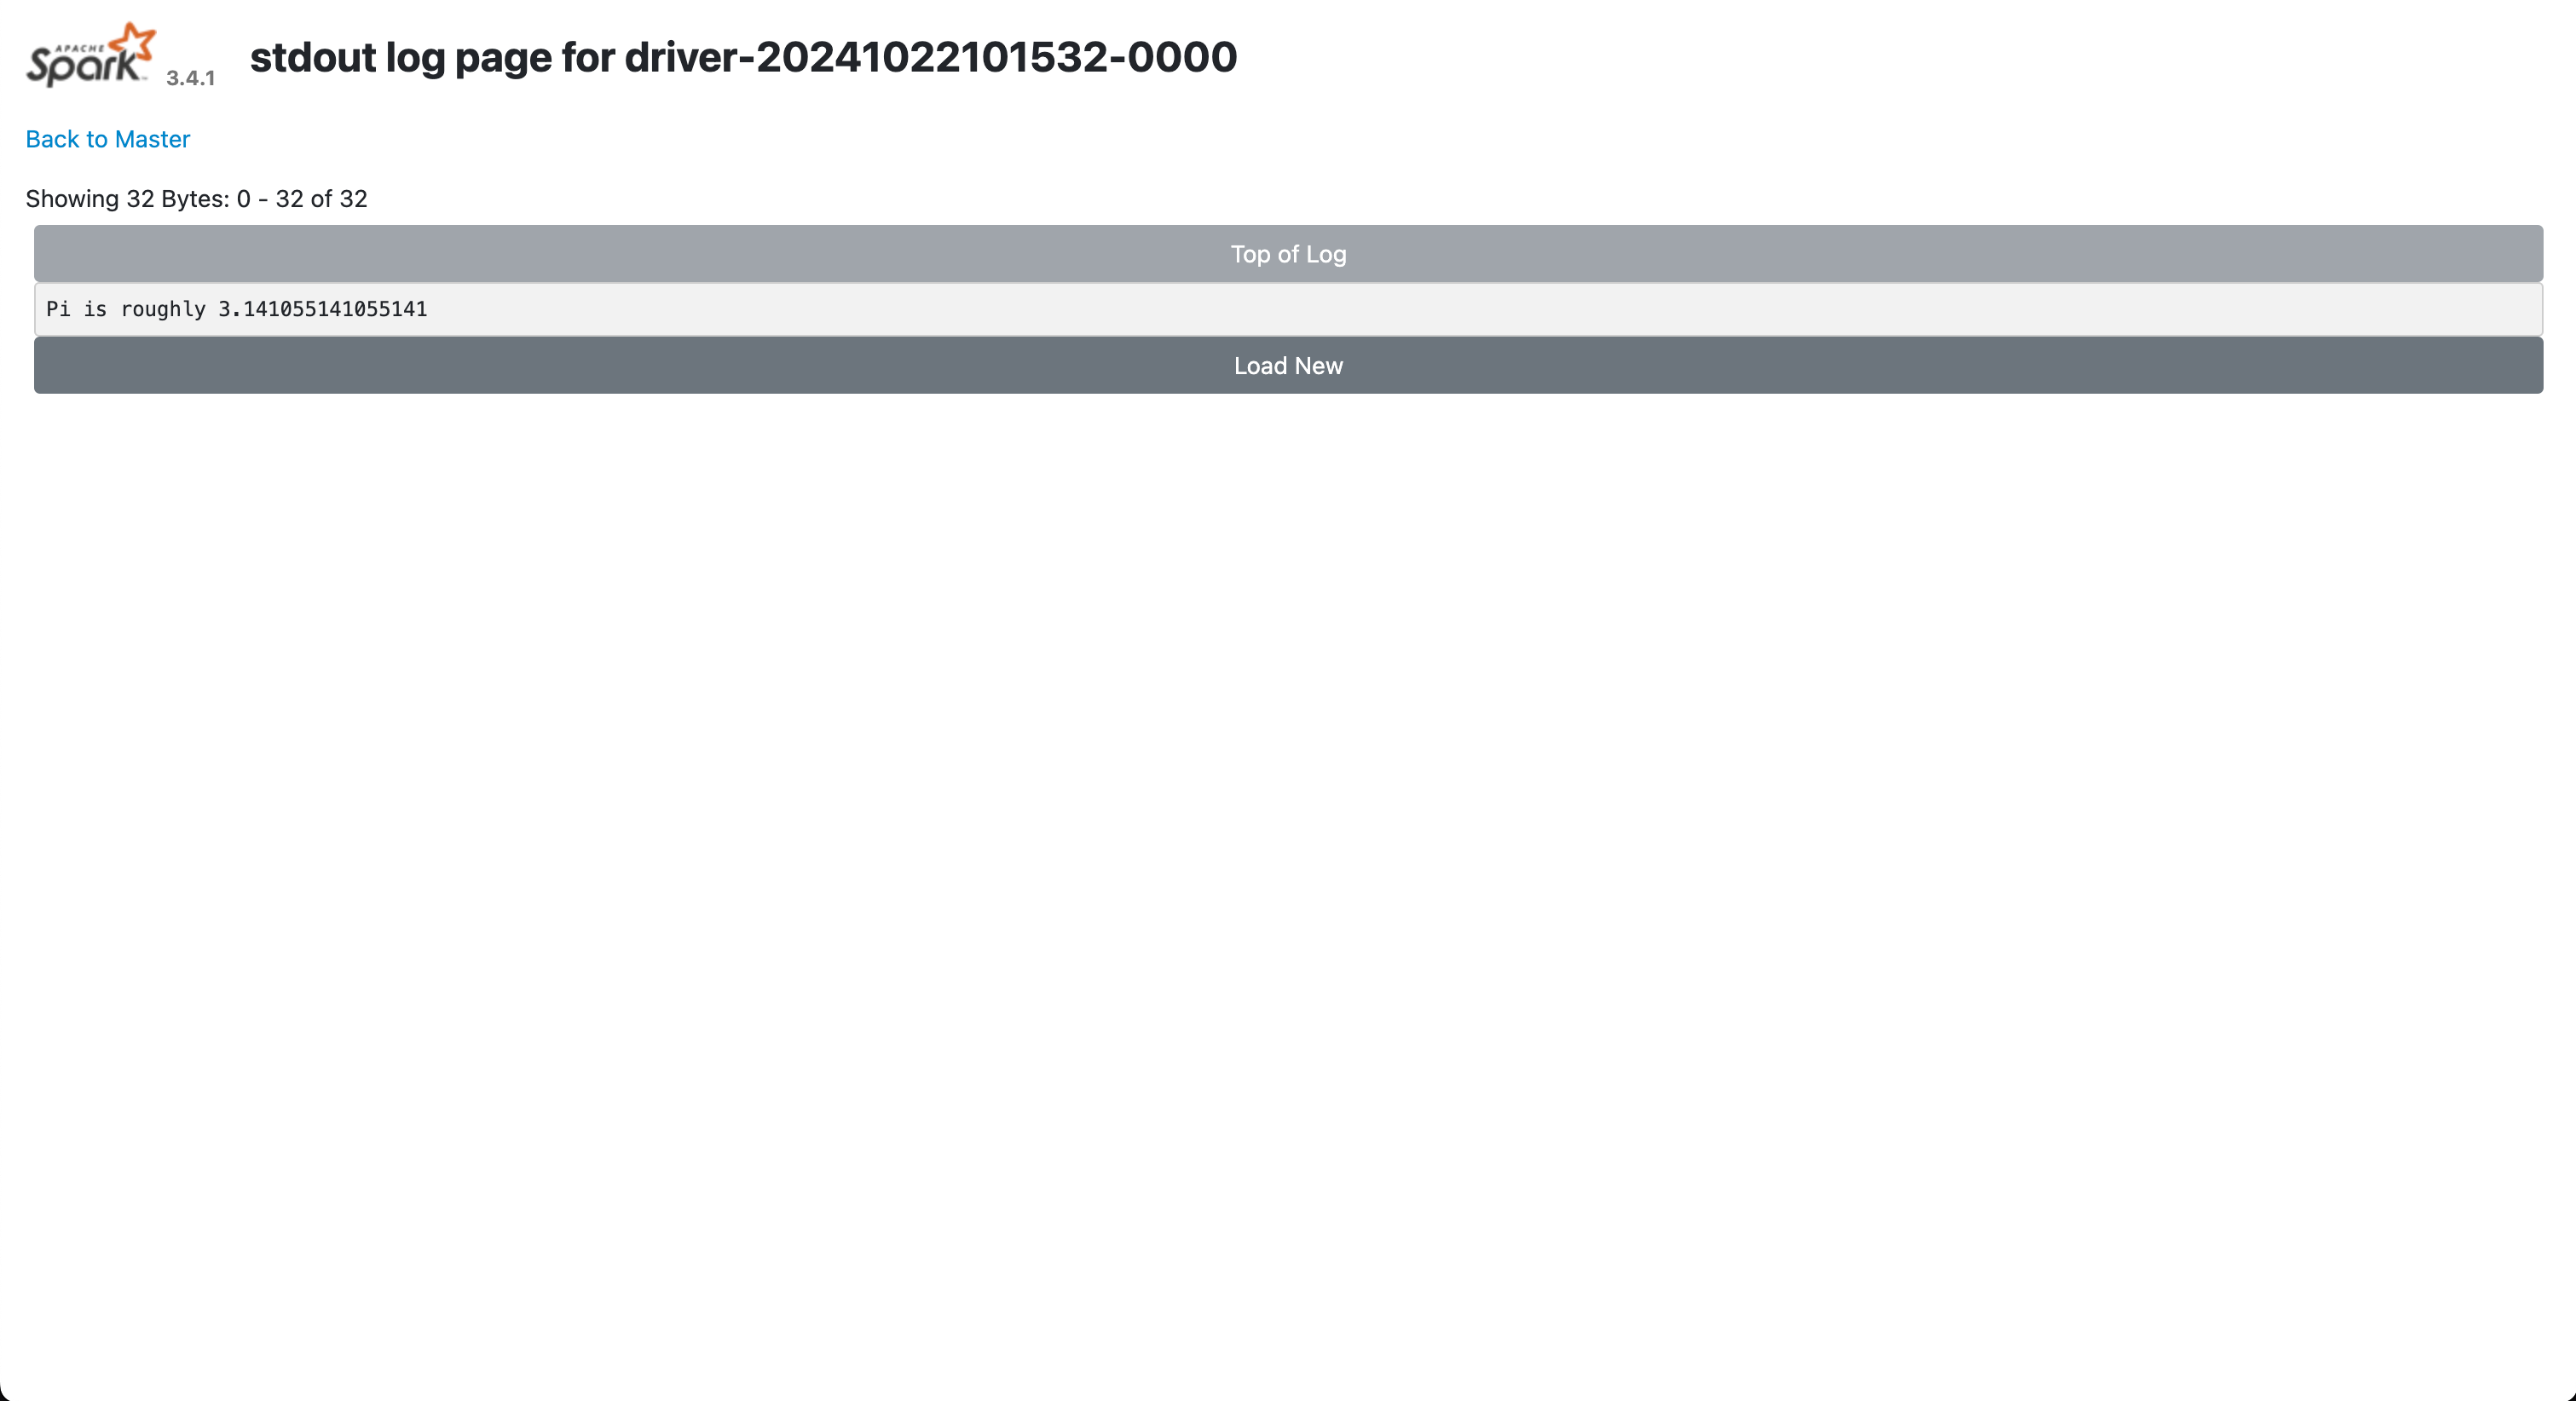
自定义作业java实例
参考地址:https://github.com/ispong/spark-job-template
自定义作业,用args接受一句sql并执行 使用exportResult()方法导出数据,在界面显示查询的数据
package com.isxcode.zhiqingyun.job;

import com.alibaba.fastjson.JSON;
import org.apache.spark.SparkConf;
import org.apache.spark.sql.Dataset;
import org.apache.spark.sql.Row;
import org.apache.spark.sql.SparkSession;

import java.util.*;

public class Execute {

    public static void main(String[] args) {

        // 从args中获取参数
        String sql = args[0];

        // 初始化结果
        List<List<String>> result = new ArrayList<>();

        // 初始化sparkSession
        try (SparkSession sparkSession = initSparkSession()) {

            Dataset<Row> rowDataset = sparkSession.sql(sql);
            rowDataset.collectAsList().forEach(e -> {
                List<String> metaData = new ArrayList<>();
                for (int i = 0; i < e.size(); i++) {
                    metaData.add(String.valueOf(e.get(i)));
                }
                result.add(metaData);
            });
        }

        // 打印结果
        exportResult(result);
    }

    /**
     * 初始化sparkSession.
     */
    public static SparkSession initSparkSession() {

        SparkSession.Builder sparkSessionBuilder = SparkSession.builder();
        SparkConf conf = new SparkConf();
        conf.set("spark.executor.extraJavaOptions", "-Dfile.encoding=utf-8");
        conf.set("spark.driver.extraJavaOptions", "-Dfile.encoding=utf-8");
        conf.set("spark.cores.max", "-1");
        return sparkSessionBuilder.config(conf).getOrCreate();
    }

    // 导出结果
    public static void exportResult(Object result) {

        System.out.println("LogType:spark-yun\n" + JSON.toJSONString(result) + "\nEnd of LogType:spark-yun");
    }
}