
计算容器
本文介绍计算容器功能的使用场景、操作流程和关键配置,帮助用户完成日常管理与业务操作。
查看计算容器
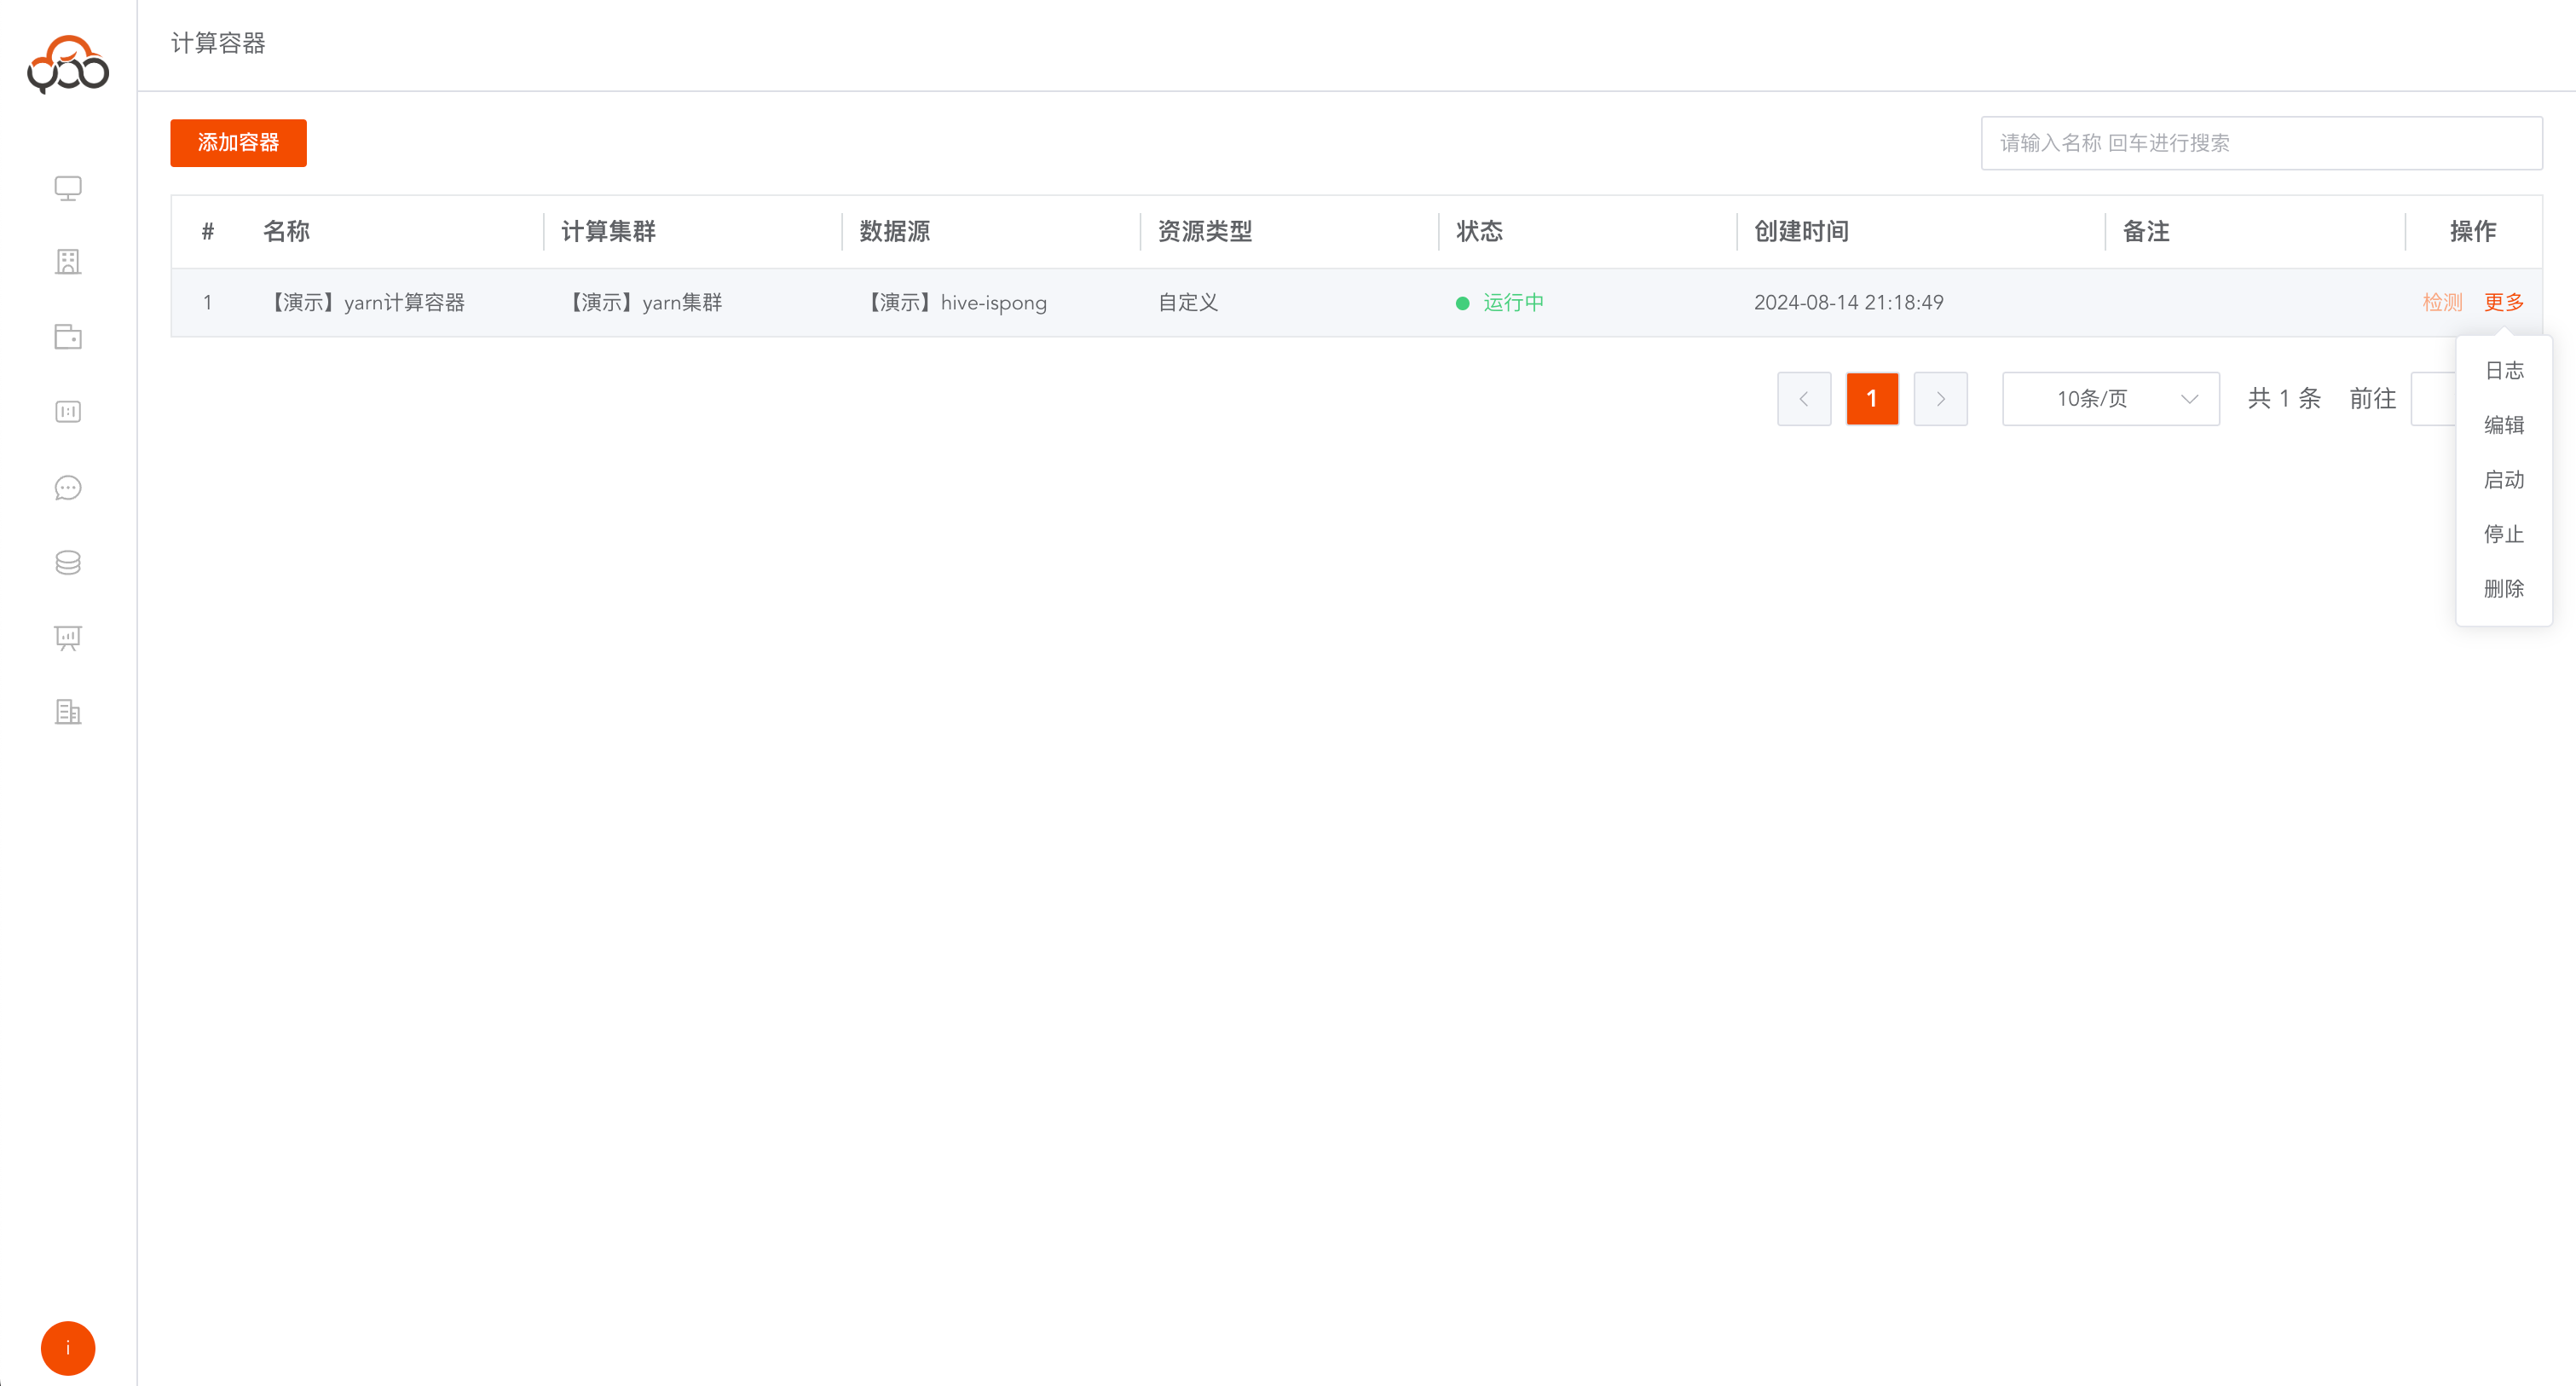
计算容器是至轻云特有的容器概念 将会启动多个不会停止的spark服务,该服务会将数据缓存到内存中,提高查询速度 支持名称搜索 通过检测按钮刷新当前容器是否正常运行
新建计算容器
点击
添加容器按钮
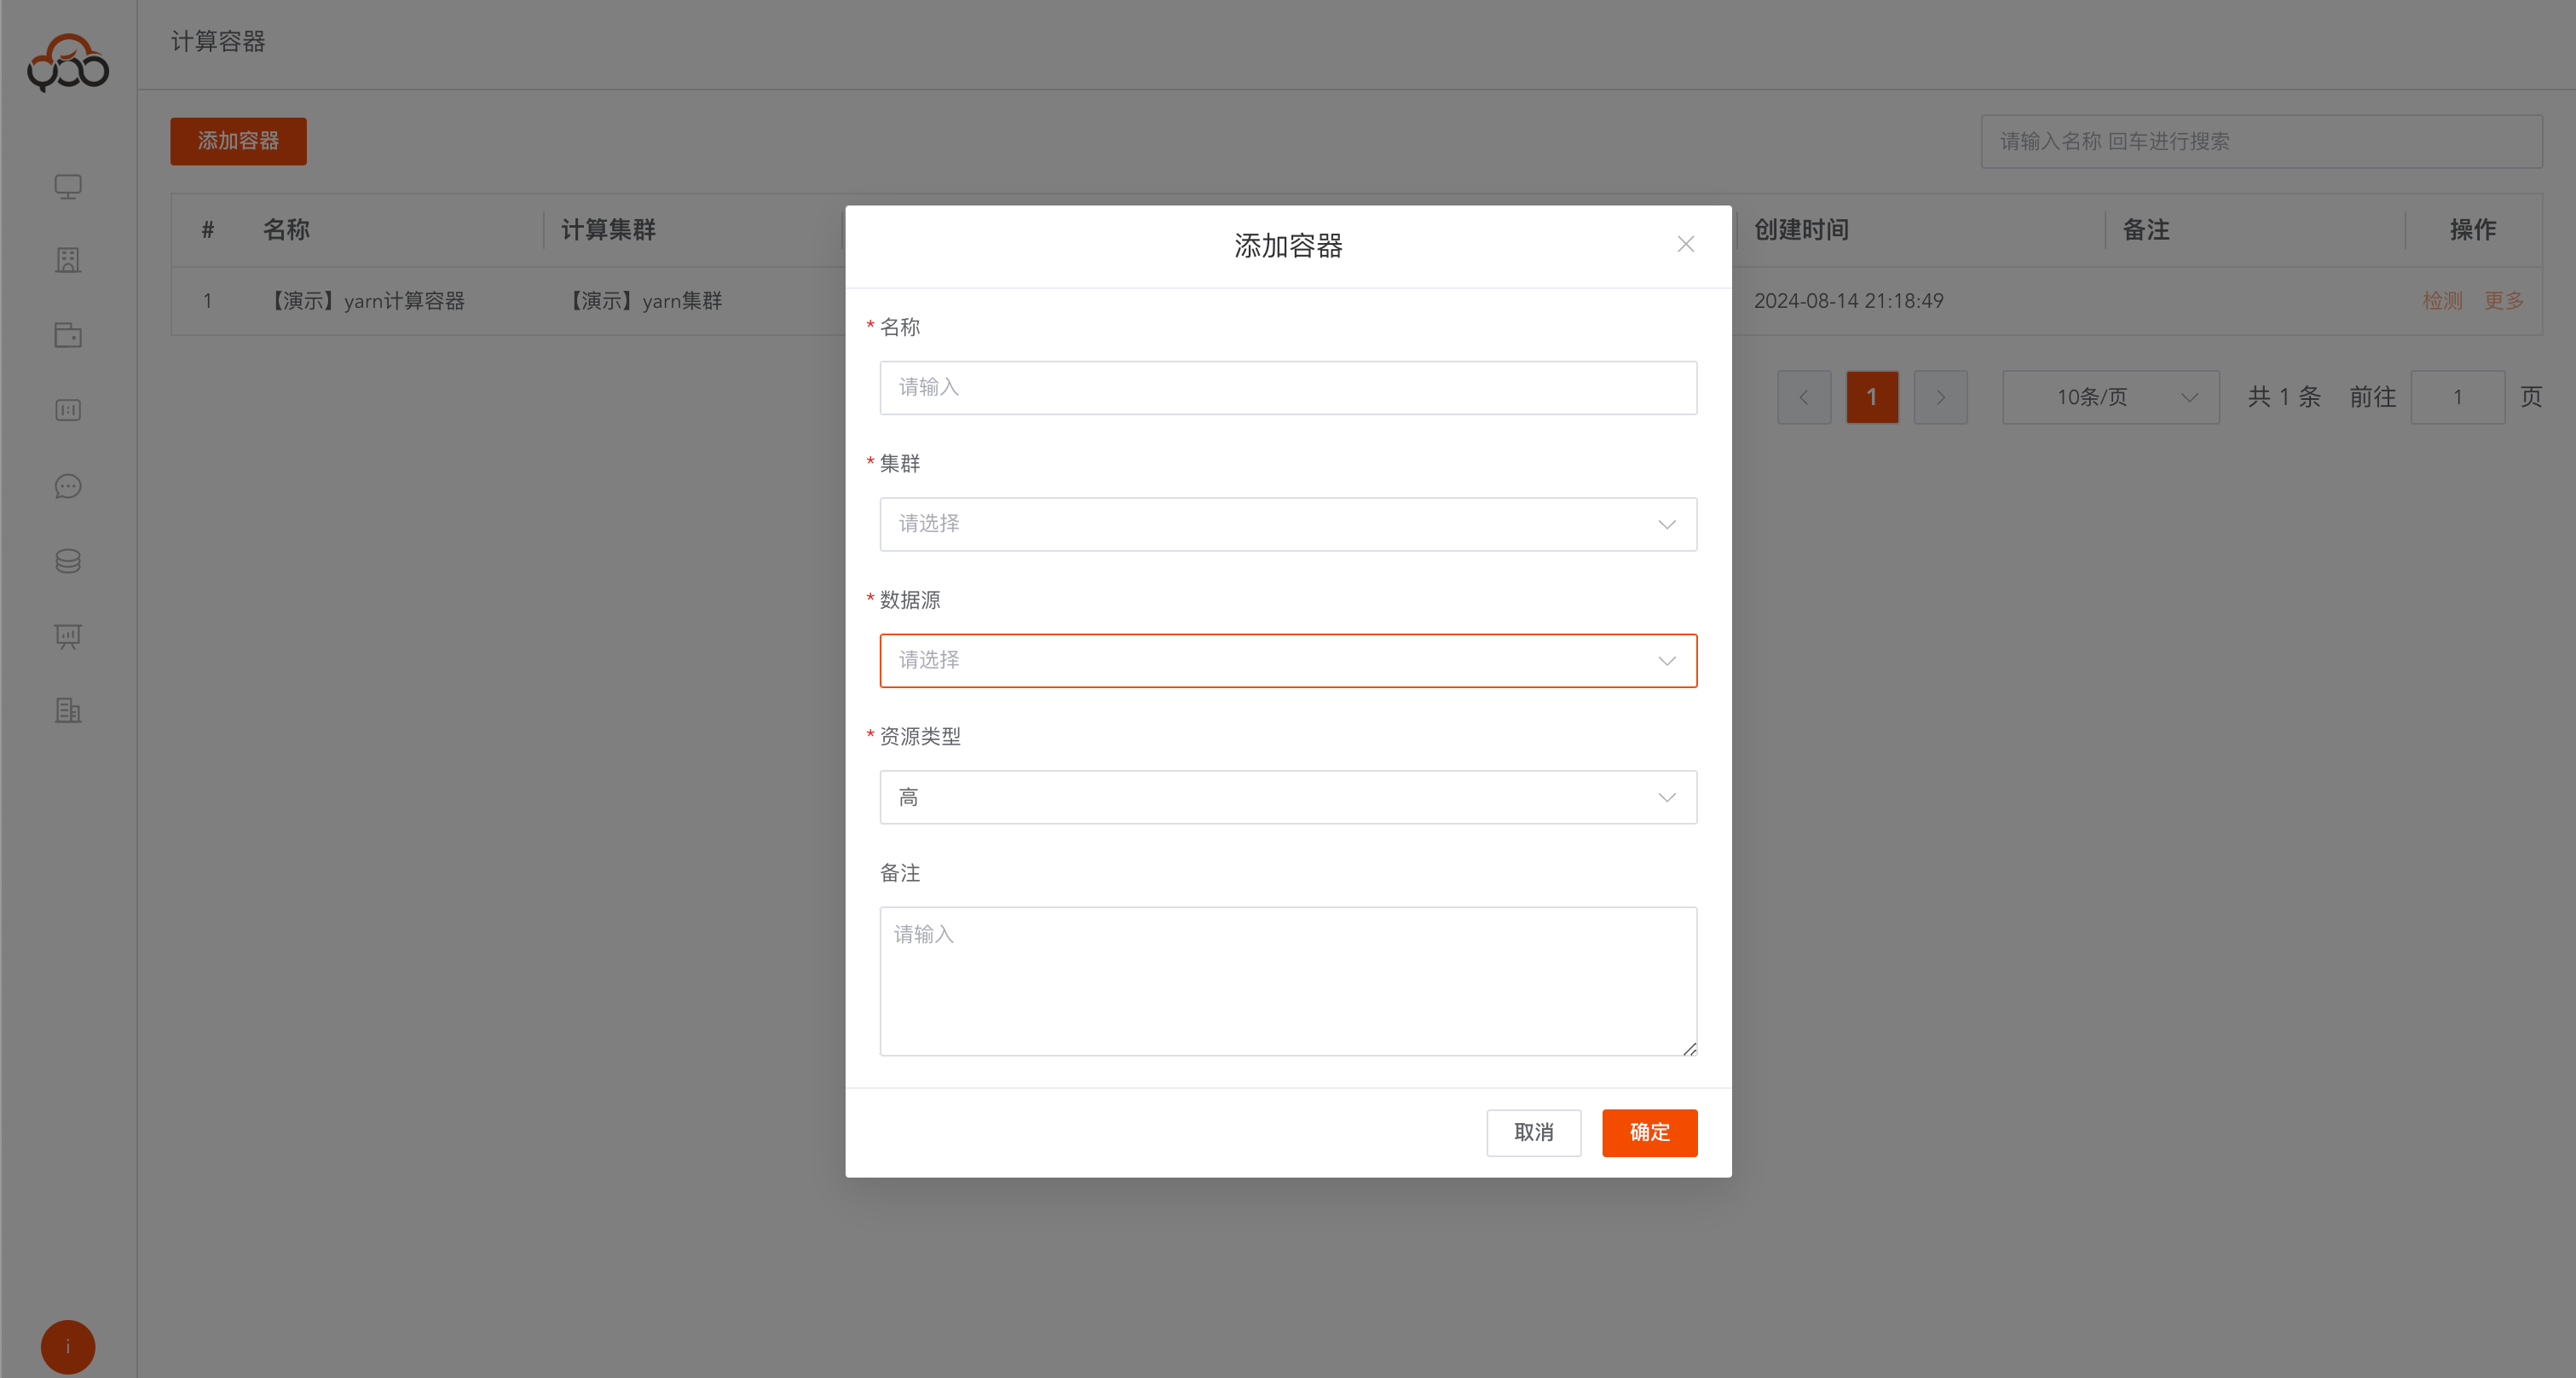
- 名称:必填,租户内名称唯一
- 集群:必填,选择提供运行容器的计算集群
- 数据源:必填,选择数据源
- 资源类型:必填,包括
高中低自定义 - 备注:非必填
资源类型说明
- 高:8GB
- 中:4GB
- 低:2GB
- 自定义:自定义SparkConfig配置,配置参考地址:https://spark.apache.org/docs/3.4.1/configuration.html
{
  "spark.cores.max": "1",
  "spark.driver.cores": "1",
  "spark.driver.extraJavaOptions": "-Dfile.encoding=utf-8",
  "spark.driver.memory": "1g",
  "spark.executor.cores": "1",
  "spark.executor.extraJavaOptions": "-Dfile.encoding=utf-8",
  "spark.executor.instances": "1",
  "spark.executor.memory": "2g",
  "spark.sql.autoBroadcastJoinThreshold": "-1",
  "spark.sql.legacy.timeParserPolicy": "LEGACY",
  "spark.sql.parquet.datetimeRebaseModeInRead": "LEGACY",
  "spark.sql.parquet.datetimeRebaseModeInWrite": "LEGACY",
  "spark.sql.parquet.enableVectorizedReader": "false",
  "spark.sql.parquet.int96RebaseModeInRead": "LEGACY",
  "spark.sql.parquet.int96RebaseModeInWrite": "LEGACY",
  "spark.sql.parquet.writeLegacyFormat": "true",
  "spark.sql.storeAssignmentPolicy": "LEGACY"
}