
实时计算
本文说明实时计算功能的使用场景、操作流程和配置项,帮助用户规范完成平台操作。
基于Spark Streaming对实时Kafka中的数据进行转换同步
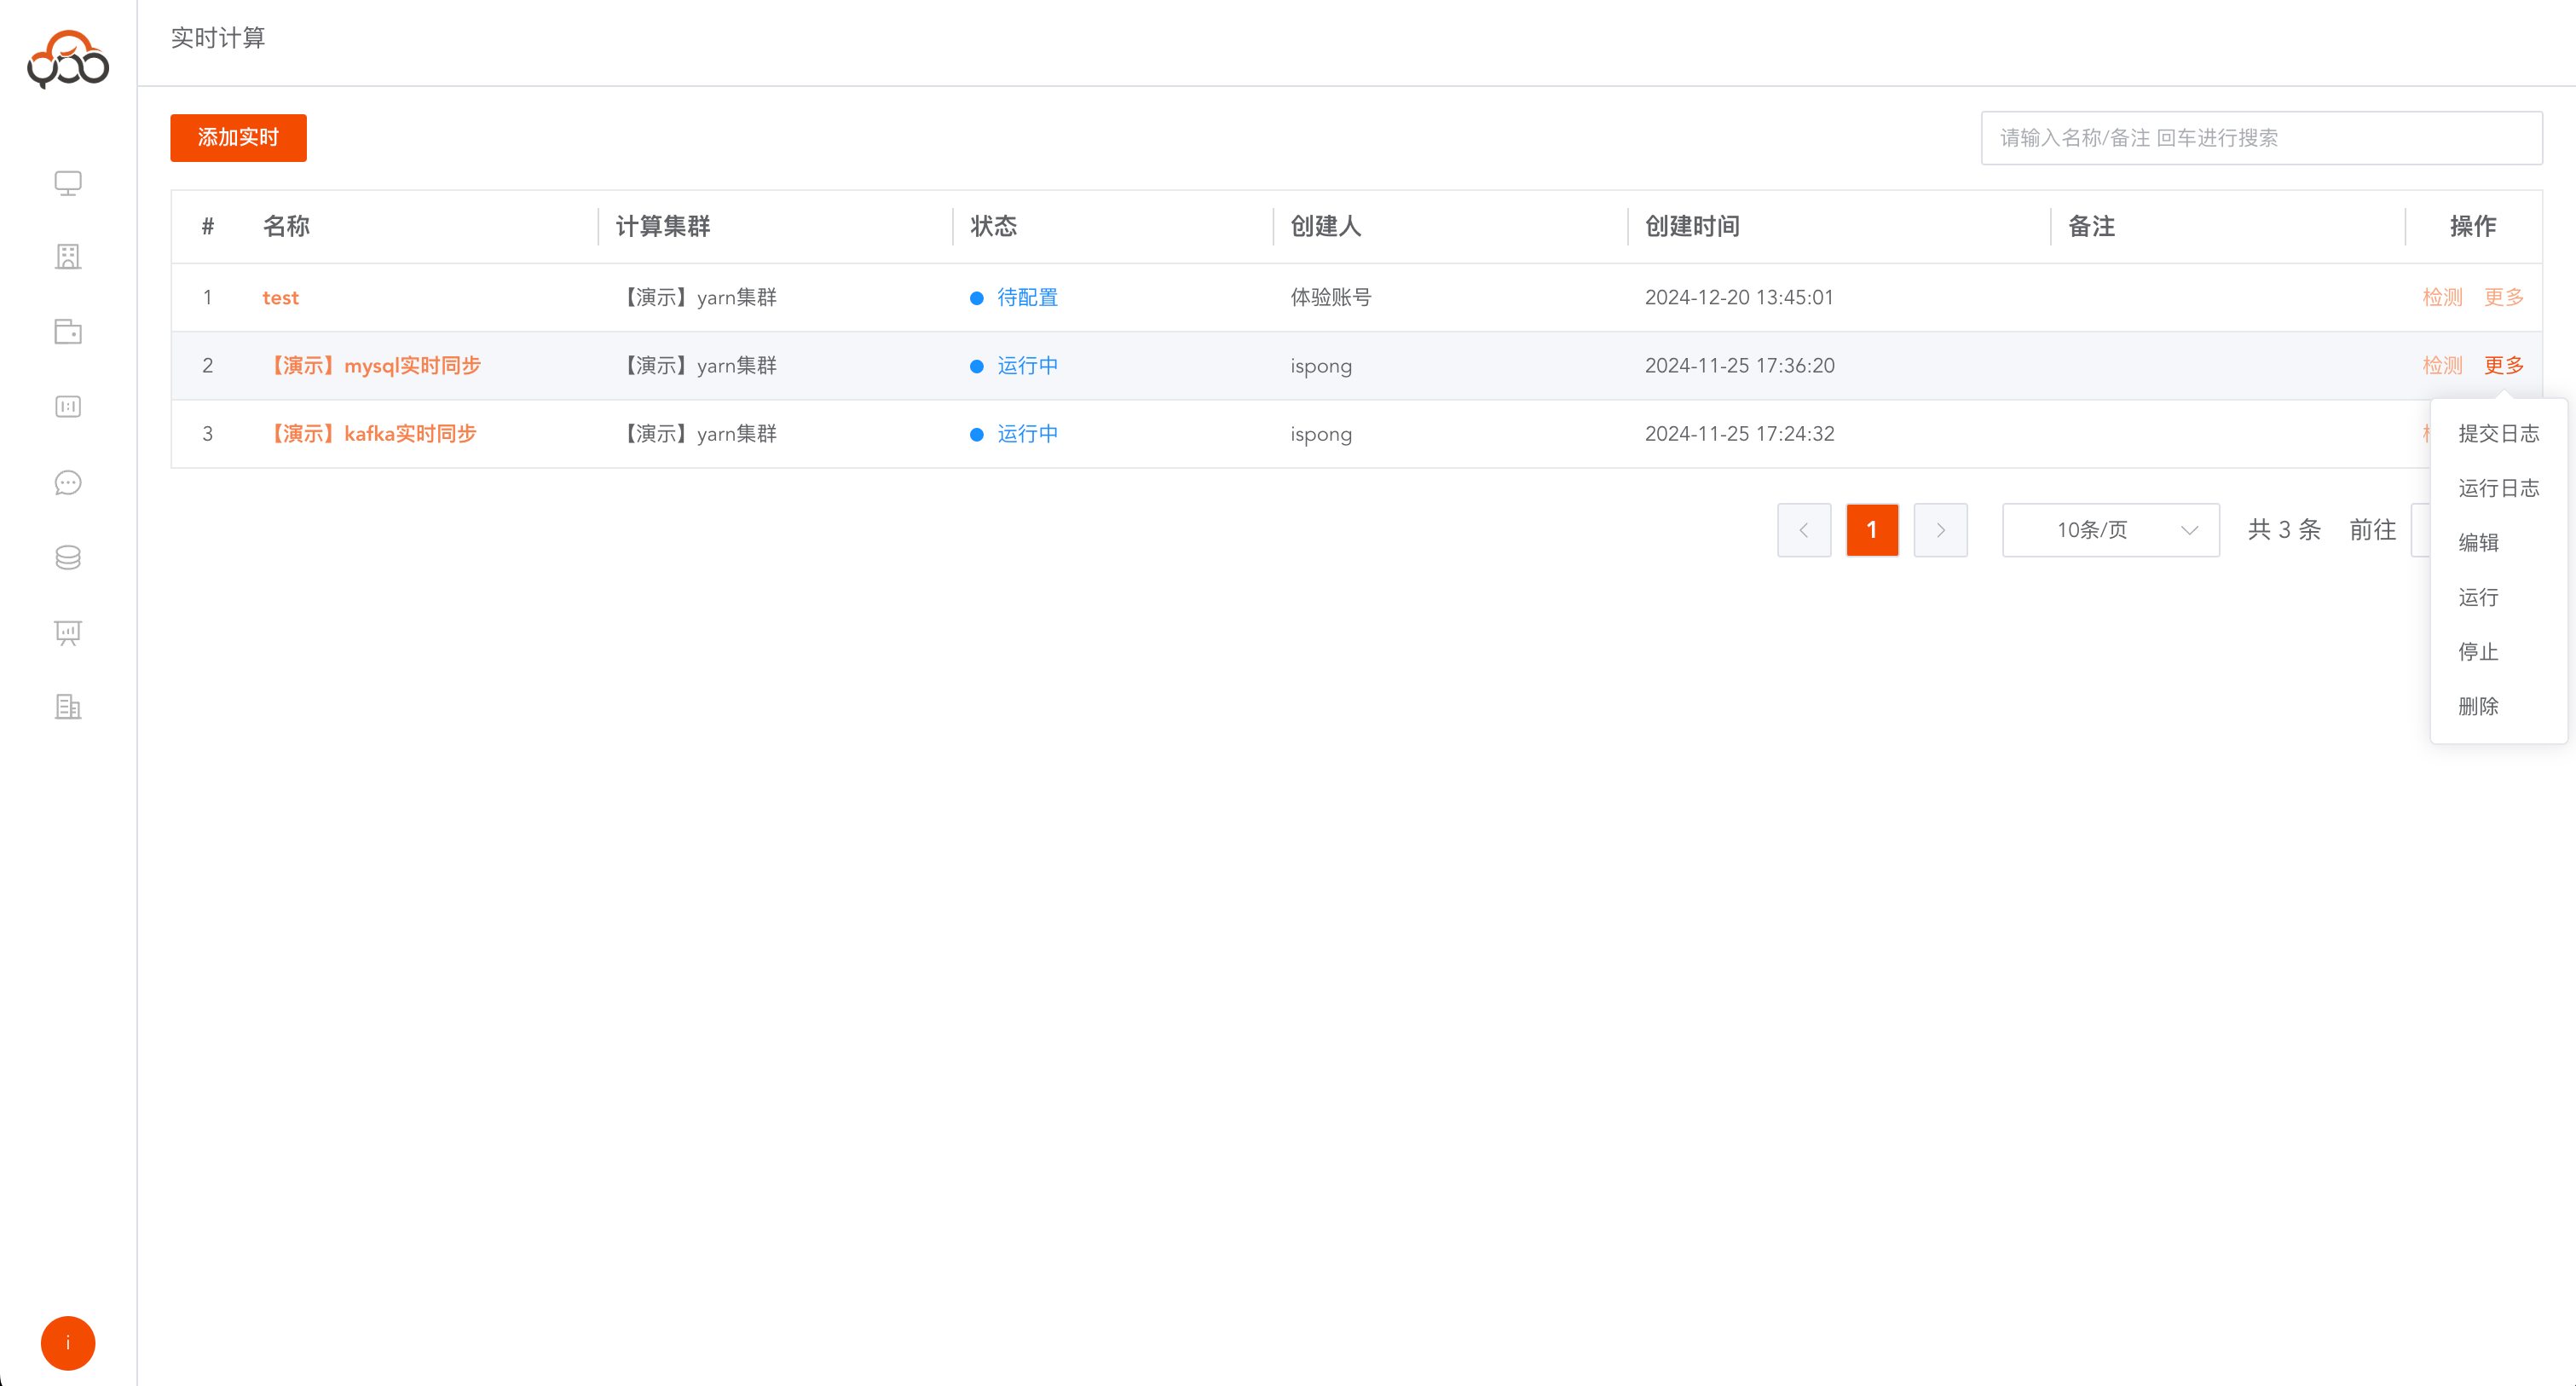
操作支持
提交日志、运行日志、编辑、运行、停止、删除操作
- 提交日志:查看实时的提交日志
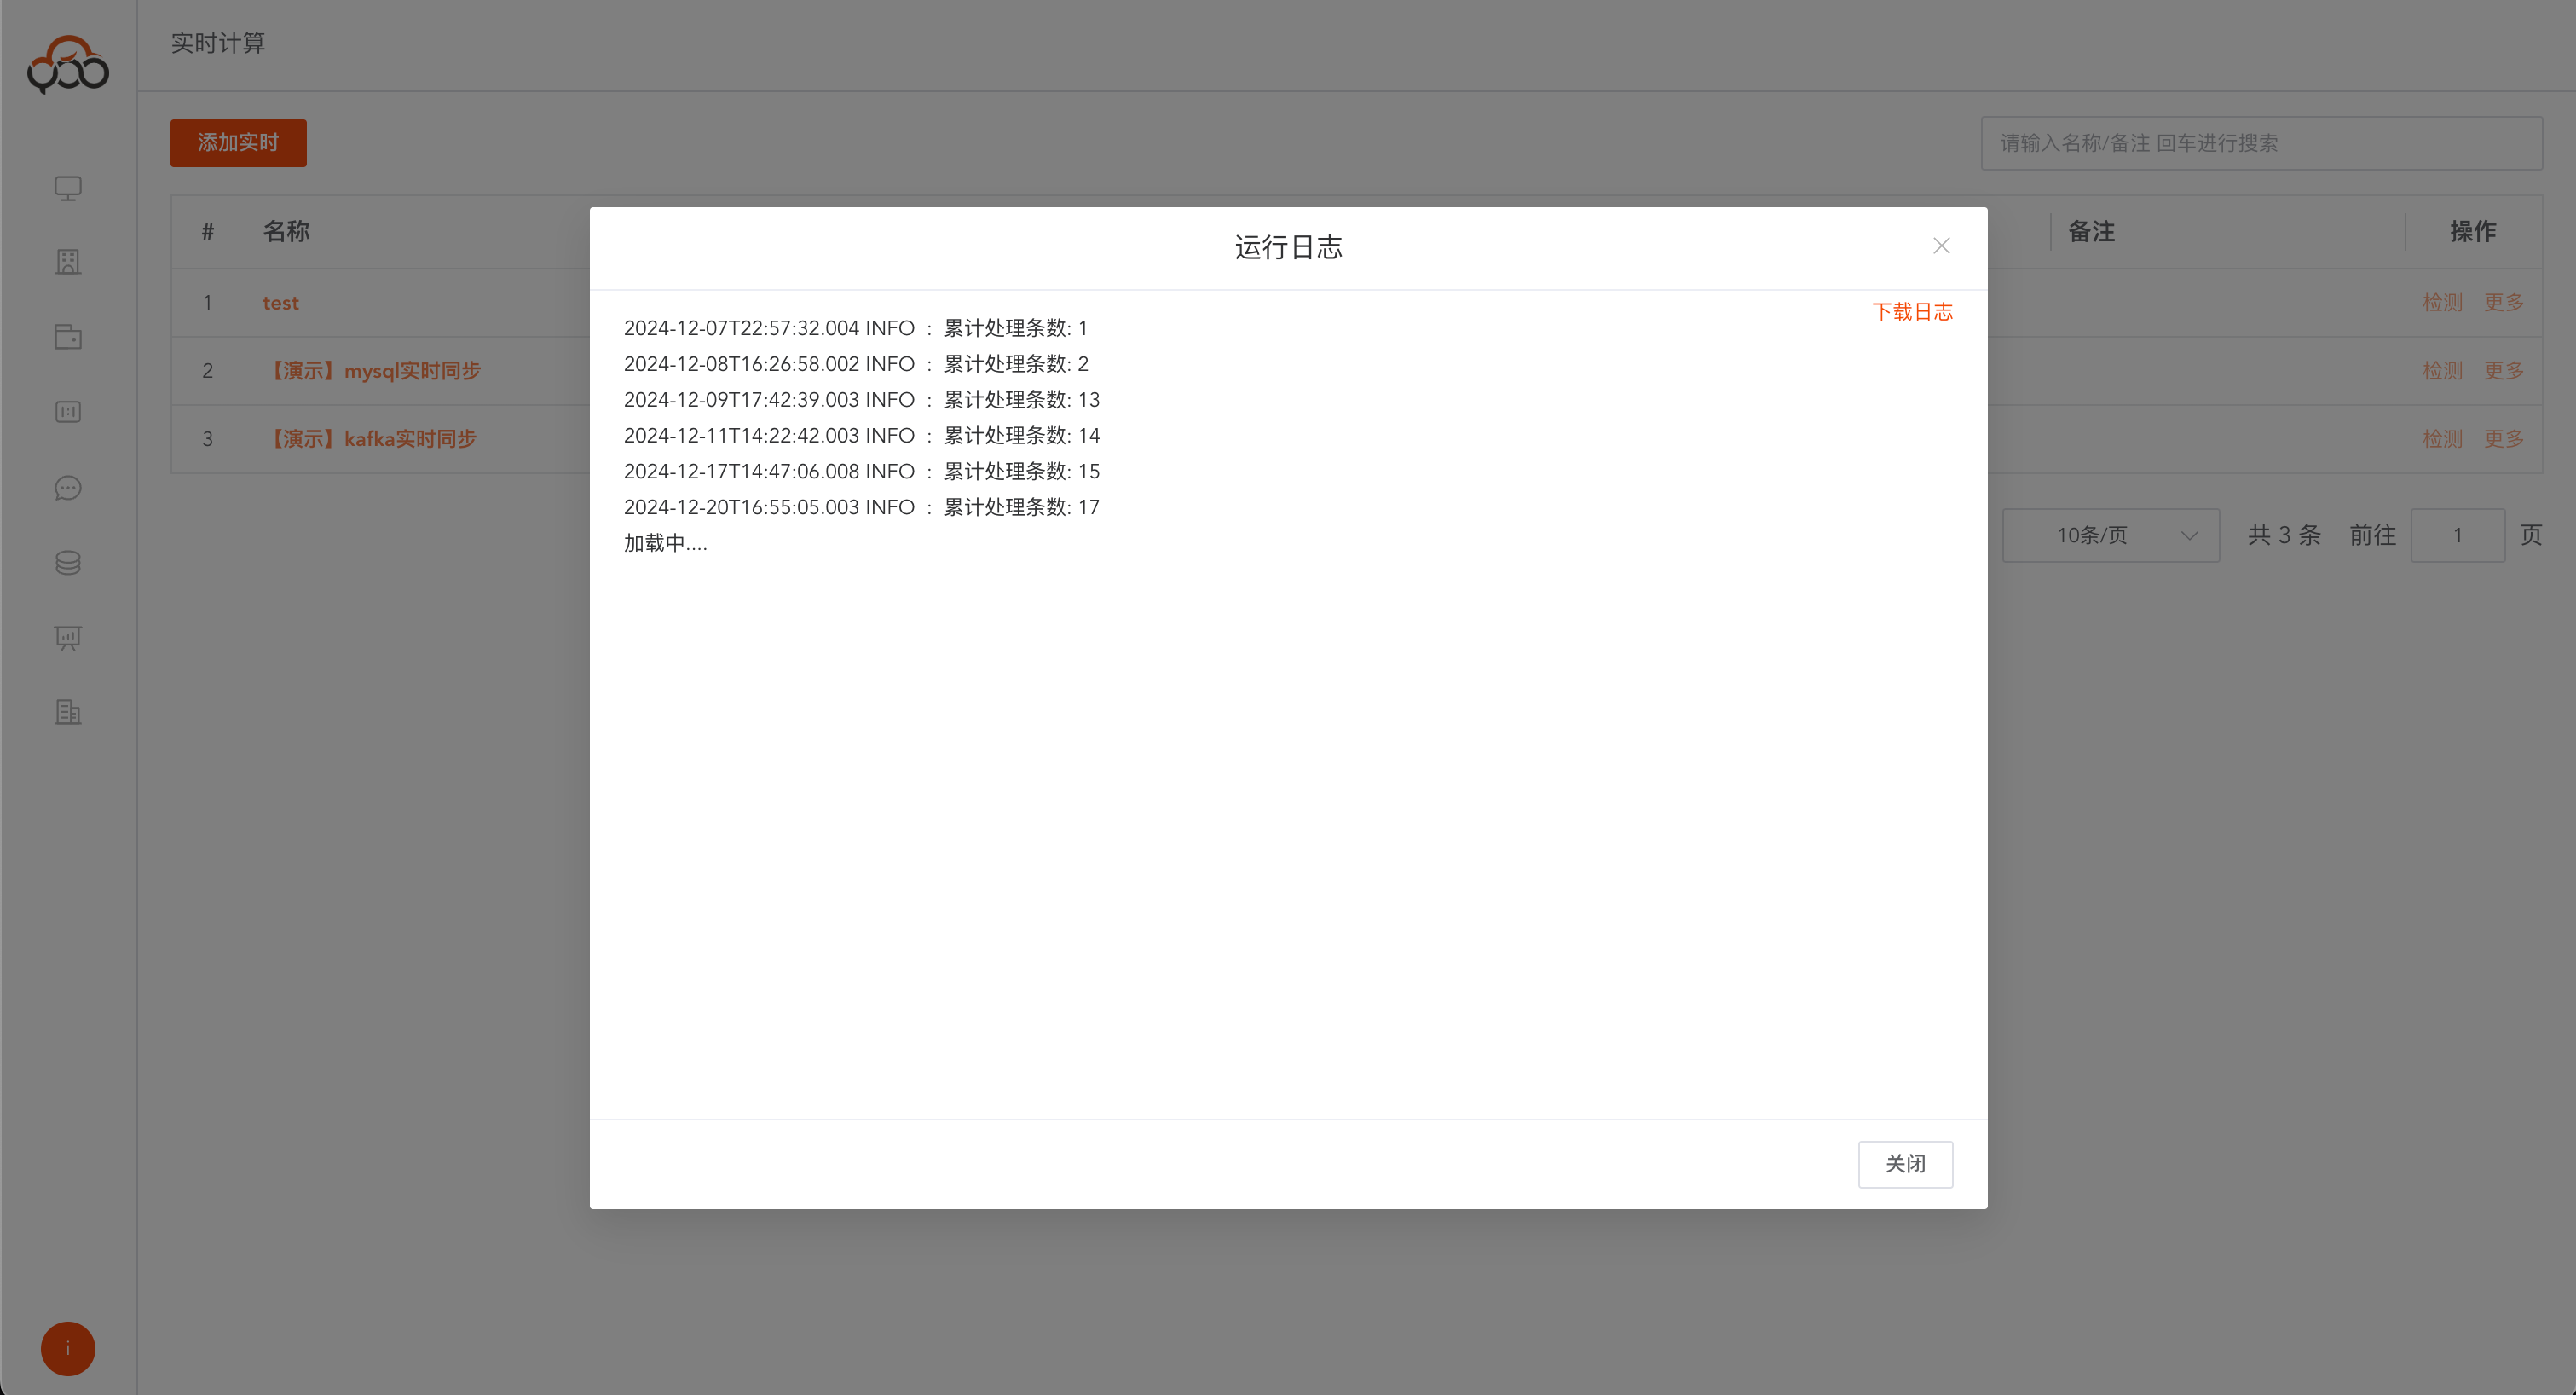
- 运行日志:查看实时同步的条数
- 编辑:编辑实时的备注和计算集群信息
- 运行:运行实时计算
- 停止:停止实时计算
- 删除:删除实时计算
查看运行日志,可查看实时已处理的数据条数
新增实时计算
点击
添加实时
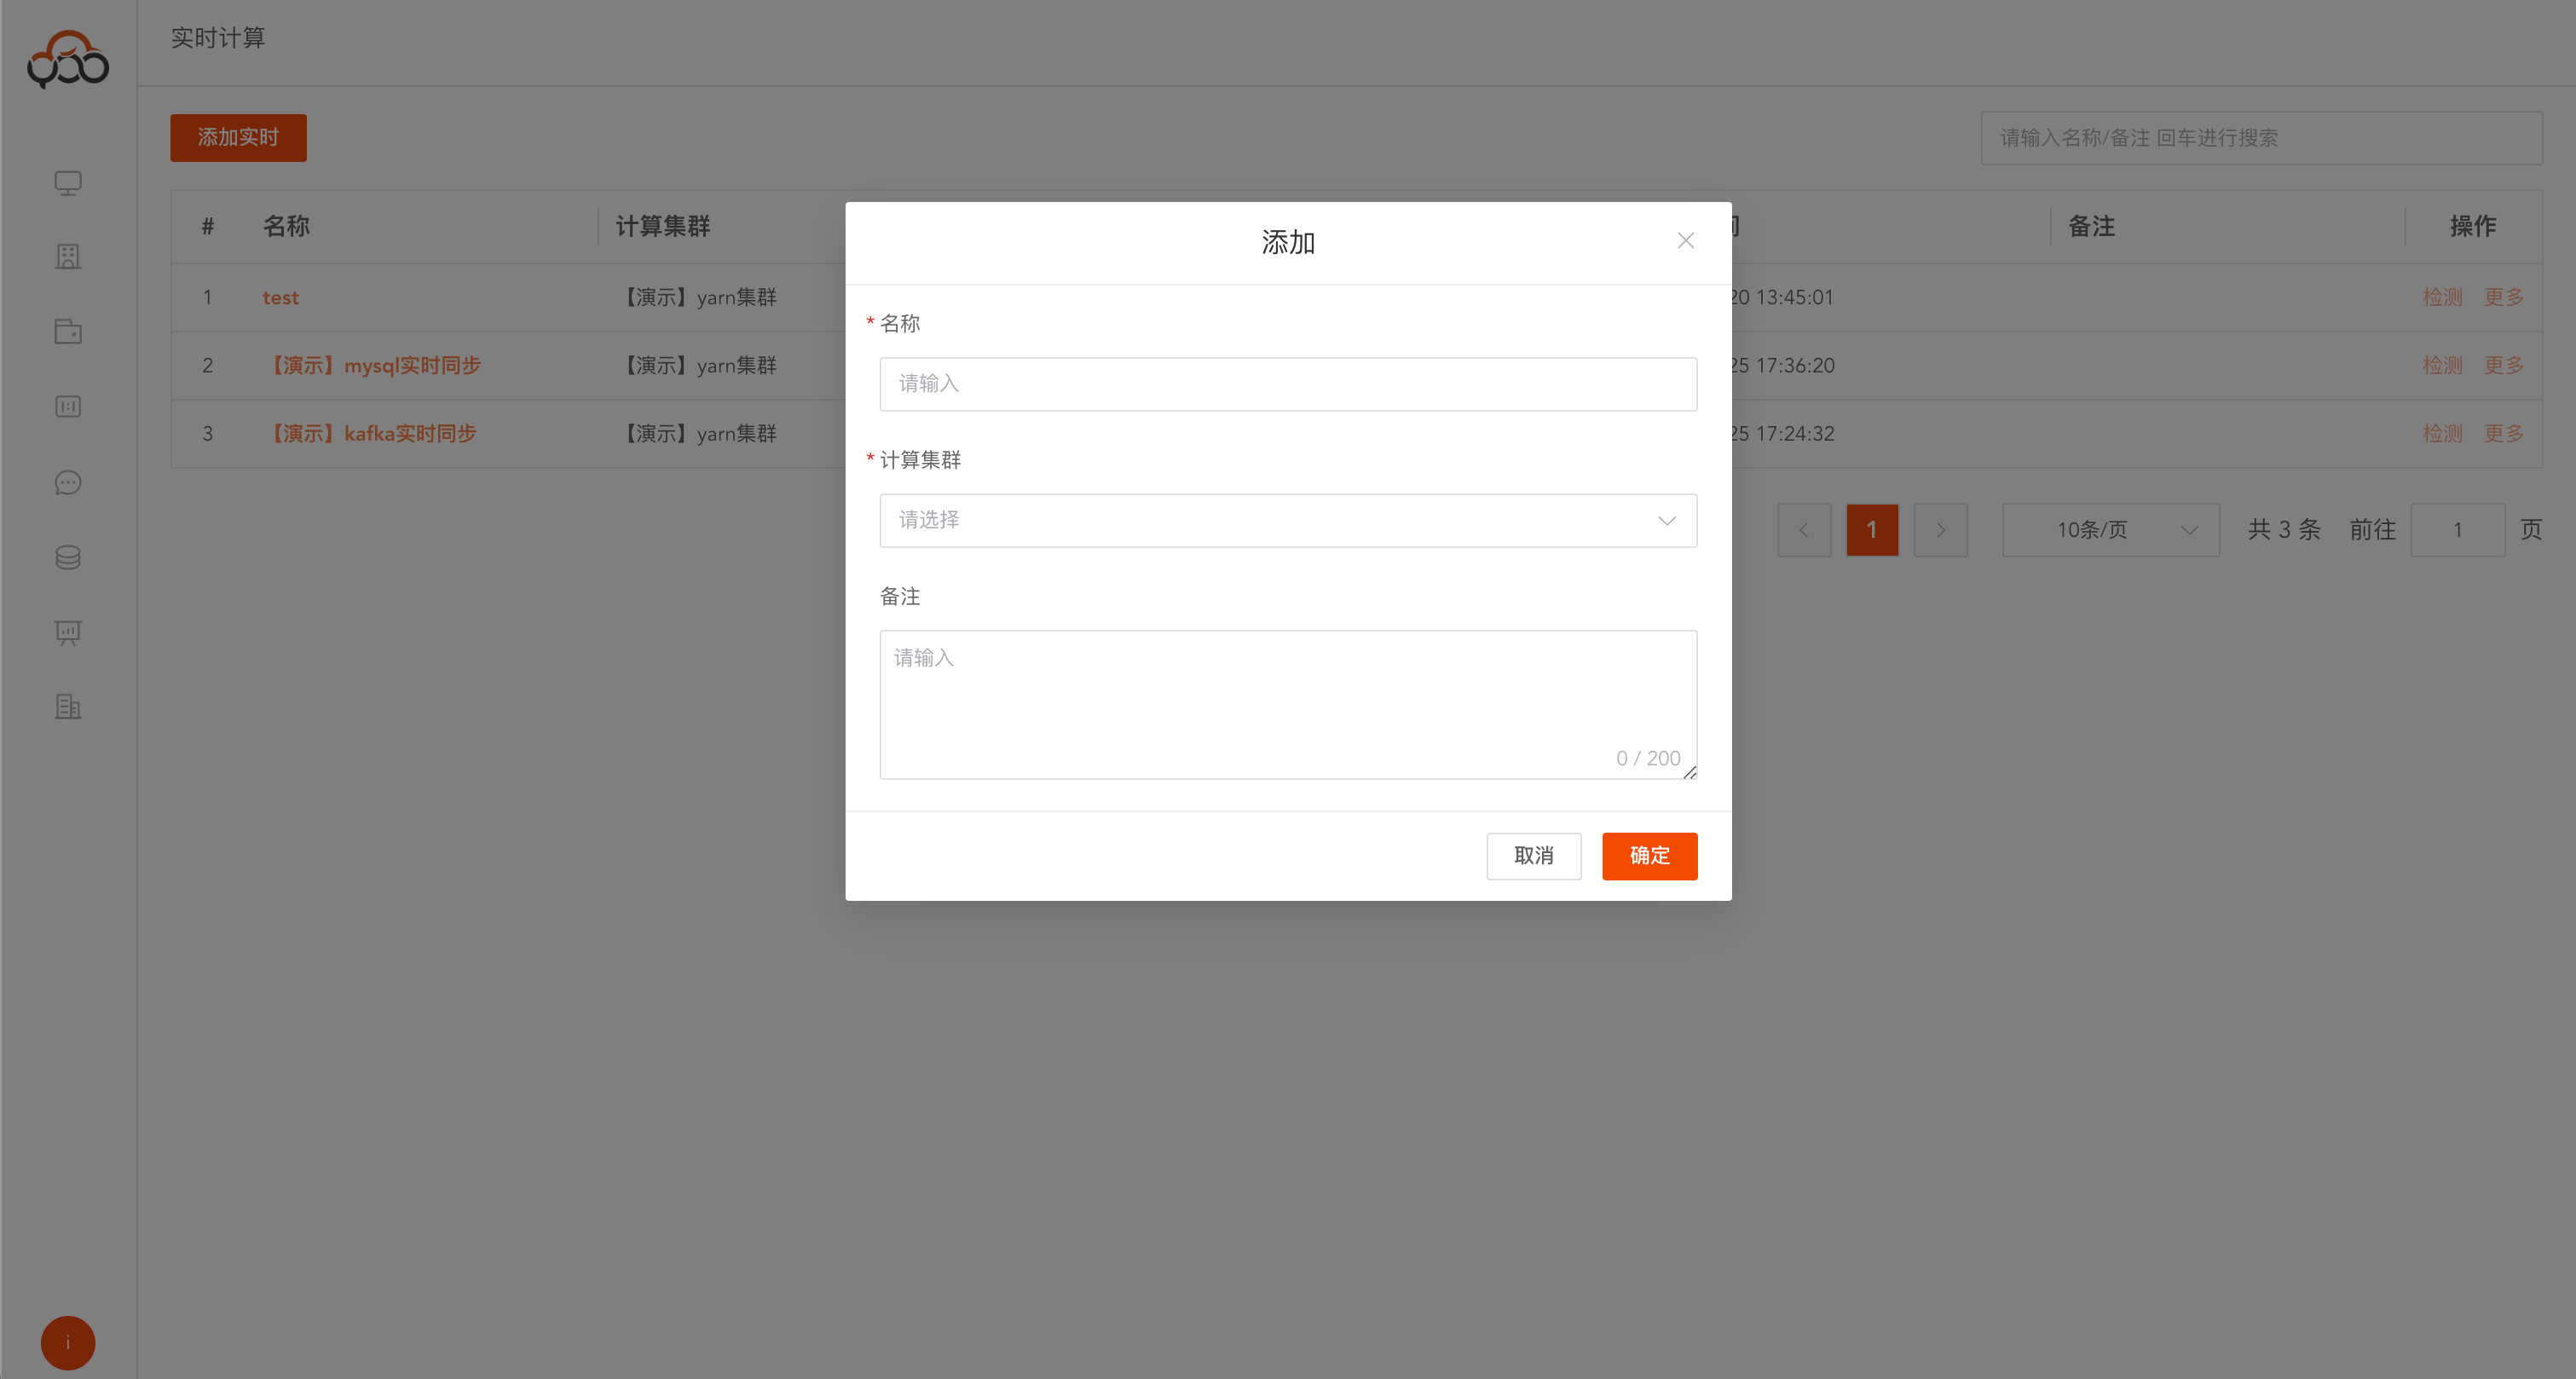
- 名称:必填,租户内名称唯一
- 计算集群:必填,指定需要提交实时计算运行的计算集群
- 备注:非必填
新增Kafka实时计算
注意:需提前安装kafka服务
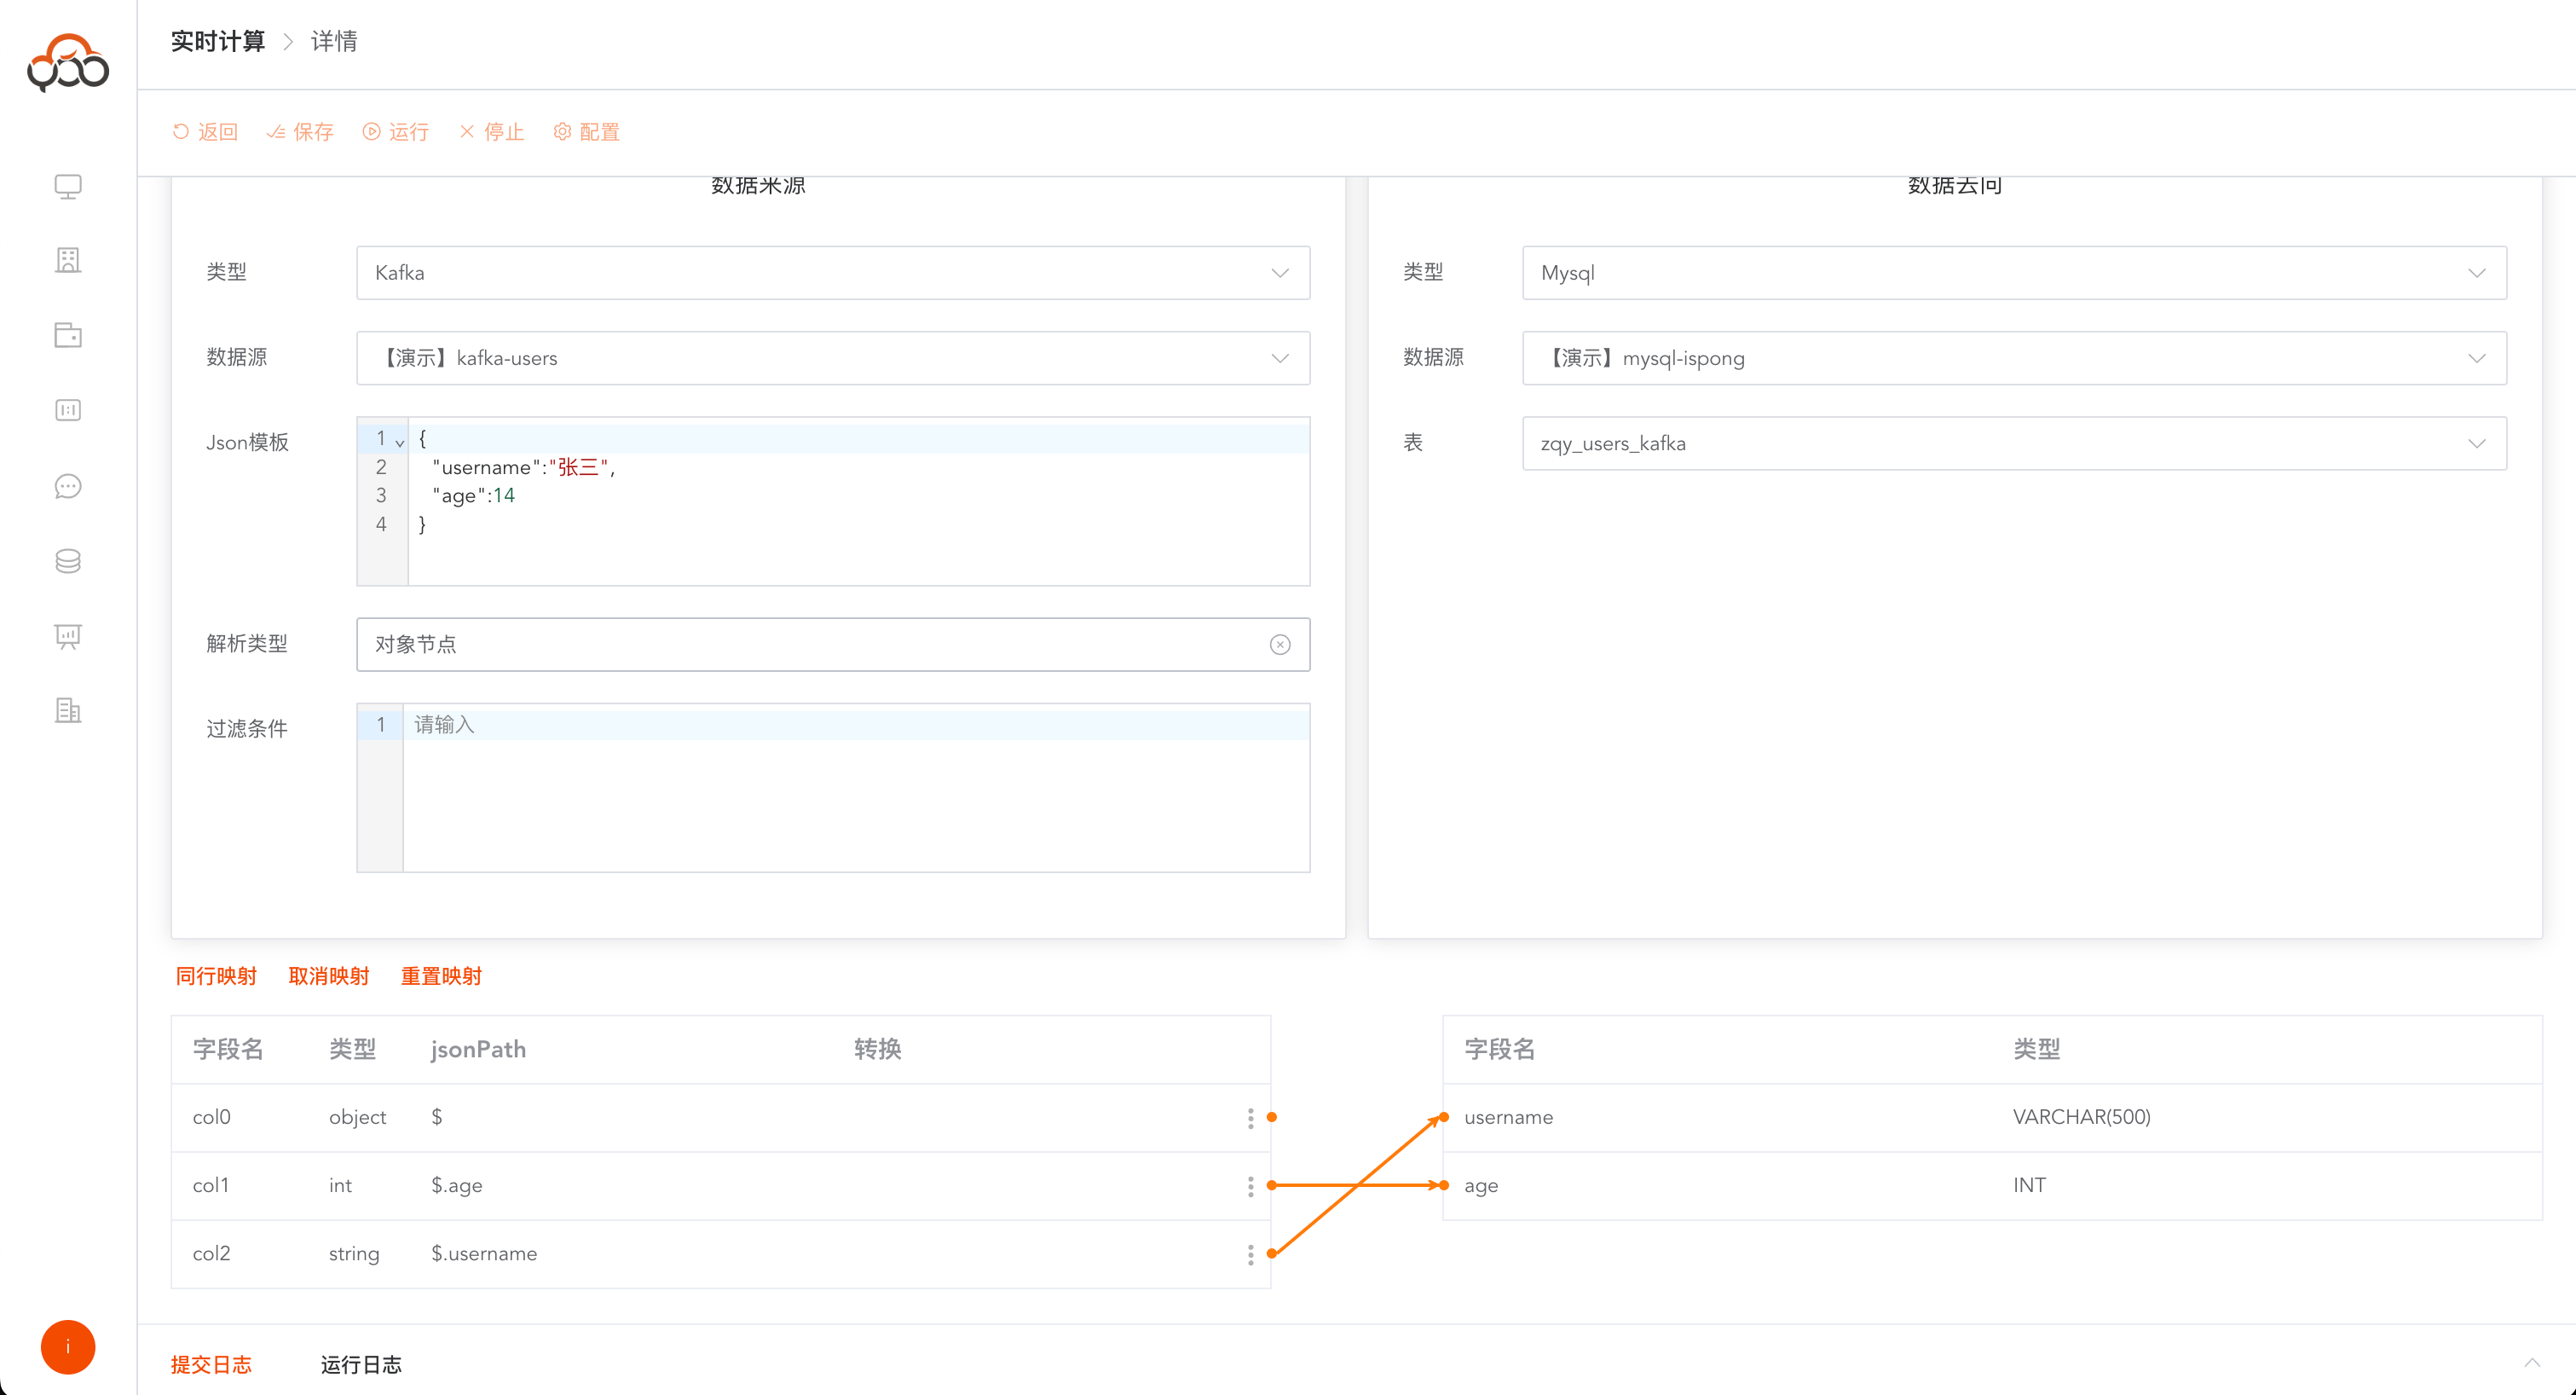
第一步,选择kafka类型,并选择kafka数据源 第二步,复制kafka管道中JSON的结构体模板 第三步,选择解析类型为
对象节点第四步,选择目标数据源和目标表 第五步,连接字段映射关系 第六步,点击运行按钮
新增数据库实时同步
注意:需提前安装debezium服务
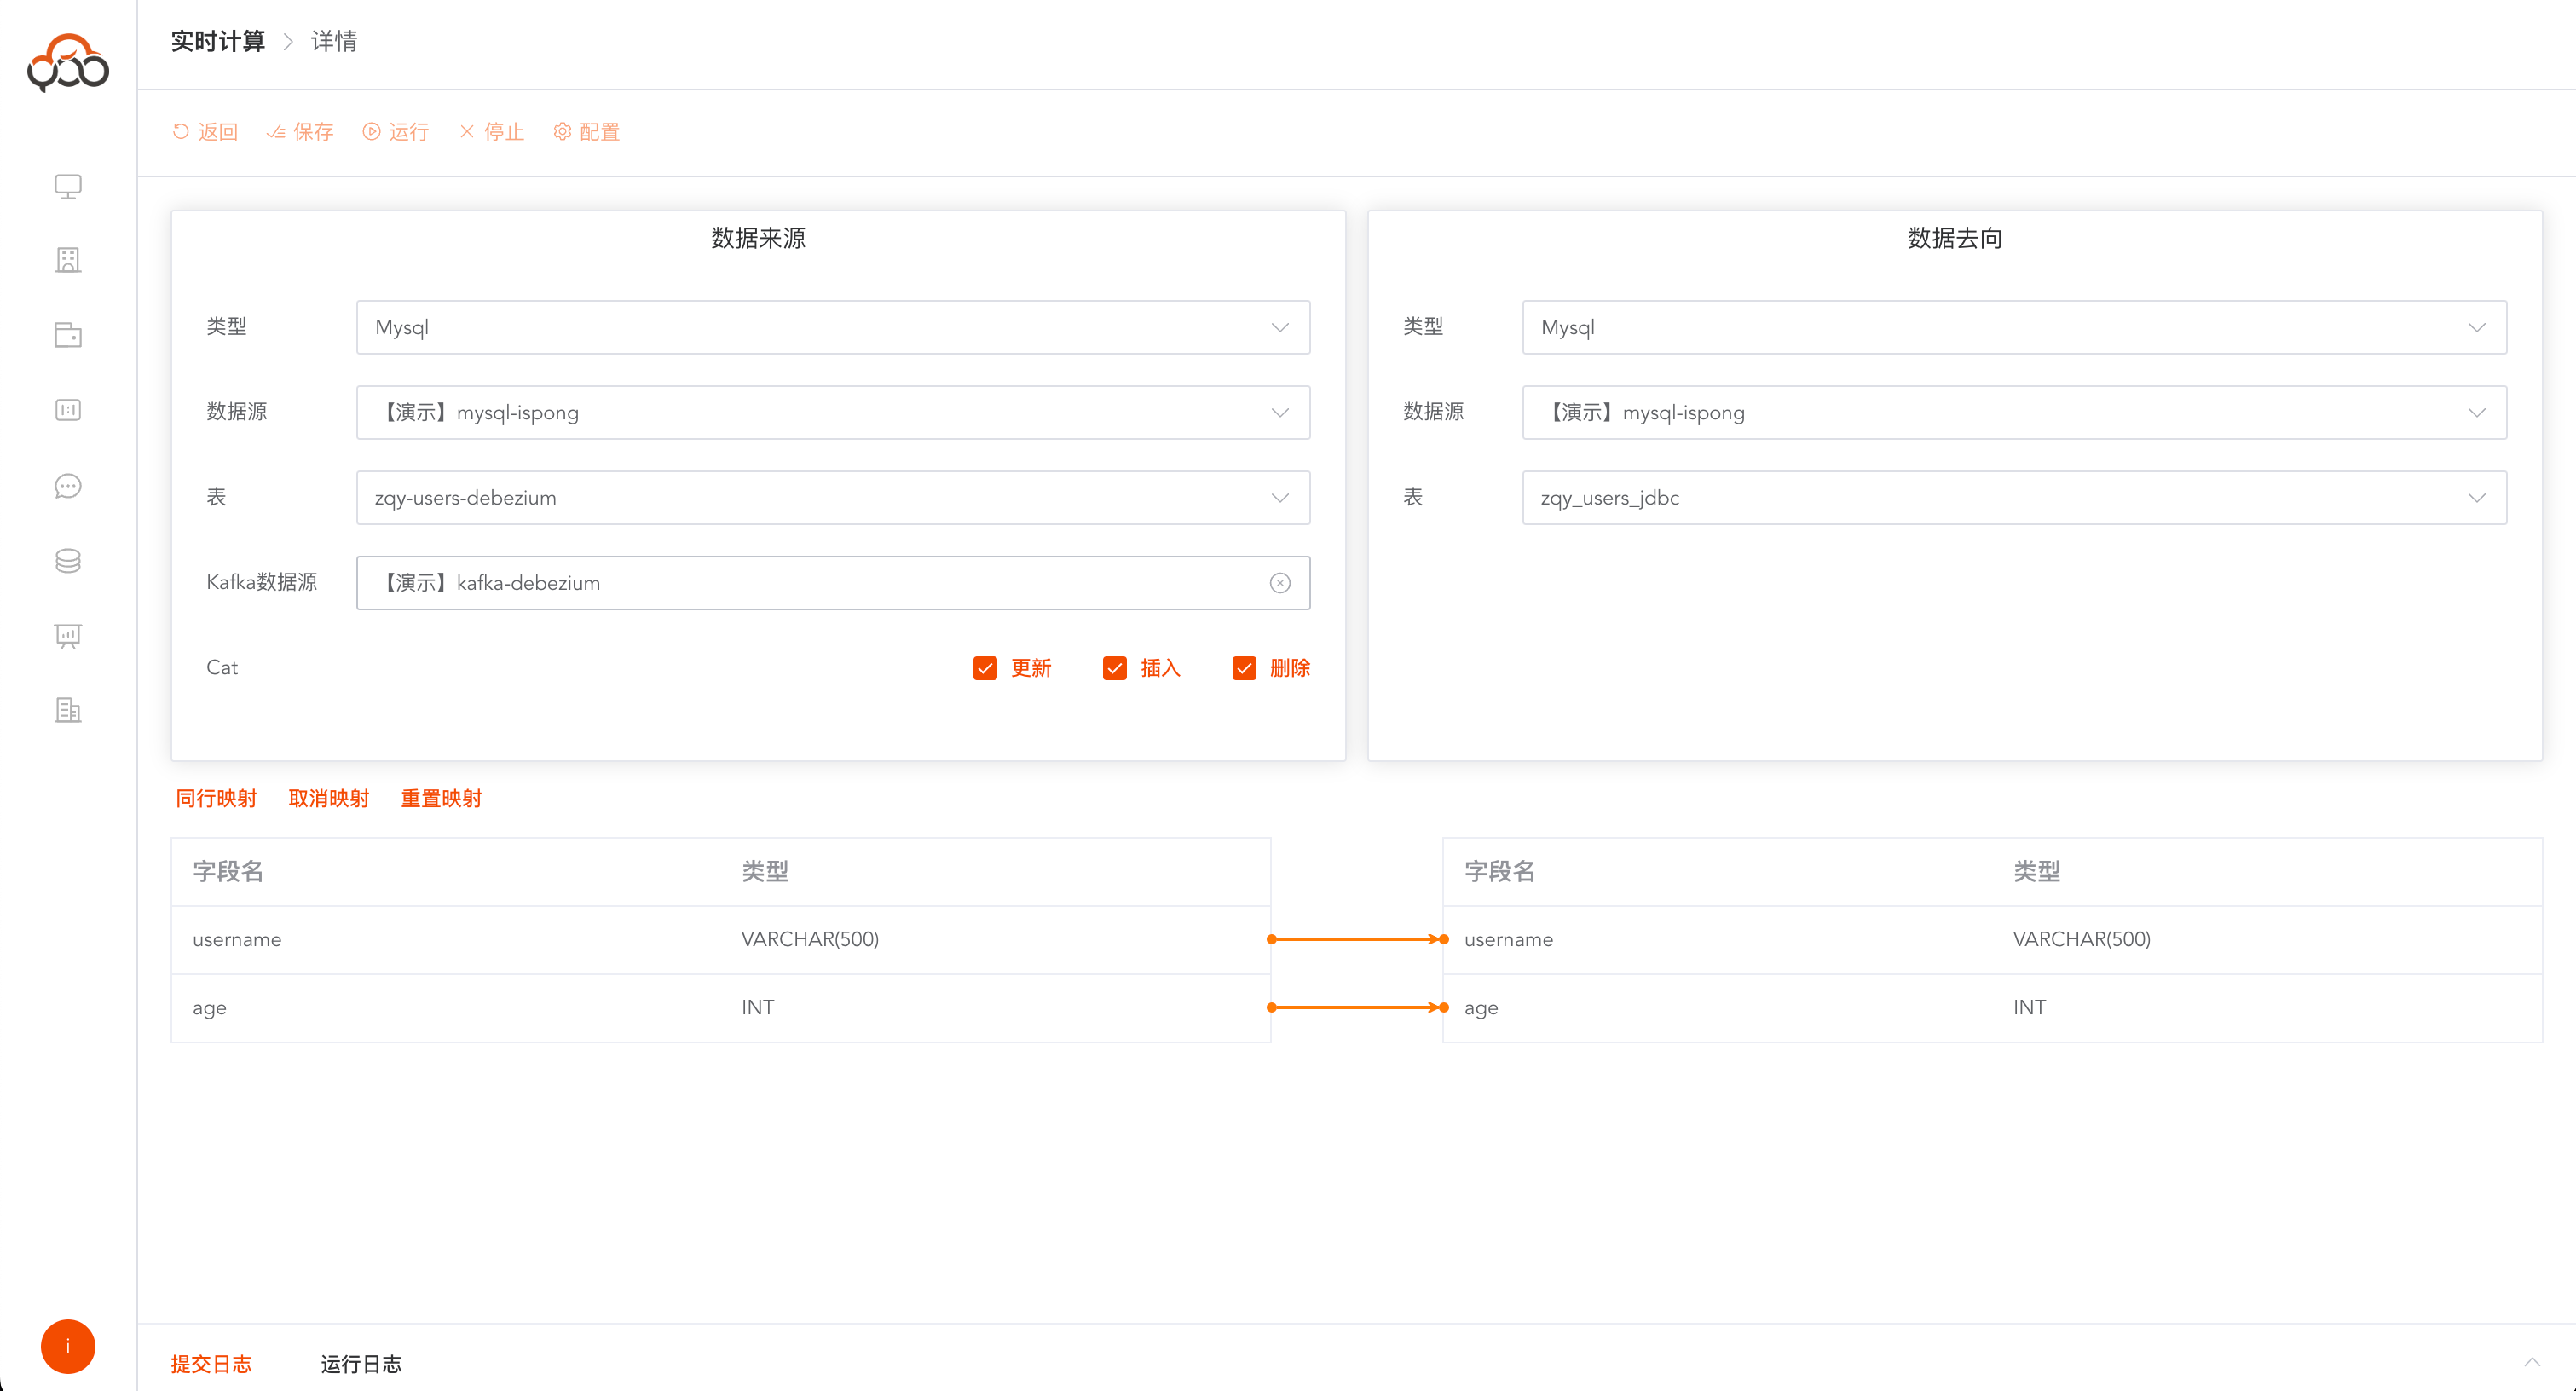
第一步,选择数据源类型,选择数据源和来源表 第二步,选择来源表对应的kafka 第三步,勾选Cat事件,支持监听以下事件
表更新、表删除、表插入第四步,选择目标数据源和目标表 第五步,连接字段映射关系 第六步,点击运行按钮